PouchDB 快速搜索

var pouch = new PouchDB('mydb');
var doc = {_id: 'mydoc', title: "Guess who?", text: "It's-a me, Mario!"};

pouch.put(doc).then(function () {
  return pouch.search({
    query: 'mario',
    fields: ['title', 'text'],
    include_docs: true,
    highlighting: true
  });
}).then(function (res) {
  console.log(res.rows[0].doc.text); // "It's-a me, Mario!"
  console.log(res.rows[0].highlighting); // {"text": "It's-a me, <strong>Mario</strong>!"}
});
(单位:千美元)现场演示(中文(简体) )
一个非常高效和准确的全文搜索引擎被建在了PouchDB上. 分析文本,索引,并为查询提供简单而强大的API. PhoneGap应用程序或任何需要离线搜索支持的网络app的理想.
这是本地插件,所以它的设计不是为了对抗CouchDB/Cloudant/etc. 如果您想搜索服务器,请使用 库奇DB Lucene 插件, (中文(简体) ), Cloudant的搜索索引或者类似的东西.
如果您需要前缀搜索(例如自动补全),那么只需使用 PouchDB 本身即可. 这个 allDocs() 财务报告和审定财务报表 query() APIs 附加软件 startkey 应该给你所有需要的前缀检查。 见 自动添加建议和前缀搜索 详细情况.
基本的符号化/stemming/stopword引擎是 朗尔,用于英文文本的优化,使用一个变体 波特喷出剂。为了优化其他语言,请检查 语言 看见 "其他语言" 节.
使用量
在浏览器中
要使用此插件, 请在 pouchdb.js 在 HTML 页面中:
<script src="pouchdb.js"></script>
<script src="pouchdb.quick-search.js"></script>
此插件也可从 Bower 获取 :
bower install pouchdb-quick-search
在节点.js/浏览/网页包中
只是npm安装它:
npm install pouchdb-quick-search
然后把它附在 PouchDB 对象 :
var PouchDB = require('pouchdb');
PouchDB.plugin(require('pouchdb-quick-search'));
API 密码
专题:
基本查询
pouch.search({
  query: 'your query here',
  fields: ['title', 'text']
}).then(function (res) {
  // handle results
}).catch(function (err) {
  // handle error
});
回应:
{ rows:
   [
     { id: 'mydoc5', score: 0.08027856564851082 },
     { id: 'mydoc3', score: 0.044194173824159216 },
     { id: 'mydoc4', score: 0.044194173824159216 }
   ],
  total_rows: 3
}
在最简单的情况下,你叫 pouch.search() 带有 query 和文件清单 field寻找。 结果包含一个匹配文档列表 ids 和 scores,从高到低排序.
如果任何文档缺少一个字段,那么它就被简单地忽略了. 您可以一次搜索一个或多个字段 .
和大多数PouchDB API一样 search() 函数返回一个承诺。 但如果你喜欢回调,你也可以使用这种风格:
pouch.search({
  query: 'your query here',
  fields: ['title', 'text']
}, function (err, res) {
  if (err) {
    // handle error
  } else {
    // handle results
  }
});
文件结构
您的文档字段可以是字符串或数组字符串。 使用点来分出深筑地. 支持深入搜索数组.
var doc = {
  _id: 'mydoc',
  name: 'Princess Peach',
  likes: ['cakes', 'go-karts', 'turnips'],
  description: {
    summary: 'Can float in Mario 2.'
  }
};

pouch.put(doc).then(function () {
  return pouch.search({
    query: 'peach',
    fields: ['name', 'likes', 'description.summary']
  });
});
回应:
{
  "rows": [
    {
      "id": "mydoc",
      "score": 0.044194173824159216
    }
  ],
  "total_rows": 1
}
获取完整文档
默认情况下, 结果只包含文档列表 ids 和 scores. 还可以使用 {include_docs: true} 获取完整文档:
pouch.search({
  query: 'kong',
  fields: ['title', 'text'],
  include_docs: true
});
回应:
{
    "rows": [
        {
            "doc": {
                "_id": "mydoc5",
                "_rev": "1-5252b7faa1062e74ef0881fc908274cd",
                "text": "This kong likes to surf!",
                "title": "Funky Kong"
            },
            "id": "mydoc5",
            "score": 0.08027856564851082
        },
        {
            "doc": {
                "_id": "mydoc3",
                "_rev": "1-895f4289f96485c86ab62b02603220ae",
                "text": "He's the leader of the bunch, you know him well.",
                "title": "Donkey Kong"
            },
            "id": "mydoc3",
            "score": 0.044194173824159216
        },
        {
            "doc": {
                "_id": "mydoc4",
                "_rev": "1-00117a7b1d05df952474206e51ff19a5",
                "text": "His coconut gun can fire in spurts.",
                "title": "Diddy Kong"
            },
            "id": "mydoc4",
            "score": 0.044194173824159216
        }
    ],
   "total_rows": 3
}
突出显示
一个非常方便的选择是 {highlighting: true},返回查询匹配的字段,以及上下文中突出显示的关键字:
pouch.search({
  query: 'kong',
  fields: ['title', 'text'],
  highlighting: true
});
回应:
{
    "rows": [
        {
            "highlighting": {
                "text": "This <strong>kong</strong> likes to surf!",
                "title": "Funky <strong>Kong</strong>"
            },
            "id": "mydoc5",
            "score": 0.08027856564851082
        },
        {
            "highlighting": {
                "title": "Donkey <strong>Kong</strong>"
            },
            "id": "mydoc3",
            "score": 0.044194173824159216
        },
        {
            "highlighting": {
                "title": "Diddy <strong>Kong</strong>"
            },
            "id": "mydoc4",
            "score": 0.044194173824159216
        }
    ],
    "total_rows": 3
}
如果你不喜欢 '<strong></strong>',也可以指定自己的 highlighting_pre 财务报告和审定财务报表 highlighting_post 字符串 :
pouch.search({
  query: 'kong',
  fields: ['title', 'text'],
  highlighting: true,
  highlighting_pre: '<em>',
  highlighting_post: '</em>'
});
回应:
{
    "rows": [
        {
            "highlighting": {
                "text": "This <em>kong</em> likes to surf!",
                "title": "Funky <em>Kong</em>"
            },
            "id": "mydoc5",
            "score": 0.08027856564851082
        },
        {
            "highlighting": {
                "title": "Donkey <em>Kong</em>"
            },
            "id": "mydoc3",
            "score": 0.044194173824159216
        },
        {
            "highlighting": {
                "title": "Diddy <em>Kong</em>"
            },
            "id": "mydoc4",
            "score": 0.044194173824159216
        }
    ],
    "total_rows": 3
}
倾斜
你用得着 limit 财务报告和审定财务报表 skip,就像与 allDocs()编号 :query() API : (英语)
pouch.search({
  query: 'kong',
  fields: ['title', 'text'],
  limit: 10,
  skip: 20
});
业绩问题 skip 适用于 allDocs()编号 :query() 这里应用不多, 因为不管怎样, 我们必须在所有的医生ID中读取并计算他们的分数, 以便正确排序 。 换句话说,无论您设定了何种值,您都会将所有匹配文档的文档ID读入内存 limit 财务报告和审定财务报表 skip。 。 。 .
然而,这将优化元数据附件,如 doc 财务报告和审定财务报表 highlighting ——它只针对你想要的子集结果.
total_rows
你也会得到一个田地, total_rows,它告诉你,如果你没有申请,你会从你的查询中获得多少文件 limit编号 :skip。您可以在页码化期间使用它来显示“有多少页还剩下”.
推动字段
如果在对象而不是阵列中通过,字段可能会被提升:
pouch.search({
  query: 'kong',
  fields: {
    'title': 1,
    'text': 5
  }
});
默认助推是 1. 相对于更长的字段,更短的字段自然被增强(见下文算法解释).
最小应匹配(毫米)
默认情况下, 查询中除了句子以外的每个名词 必须 显示在文档的某处,以便匹配。 如果你想放松这一点,只允许一个子集 术语匹配,使用 mm (“ 最小应匹配 ” ) 选项, 其模式为 : 索尔的 mm 选项。 。 。 .
例1:文件必须包含两个术语 'donkey' 财务报告和审定财务报表 'kong'数字 :
pouch.search({
  query: 'donkey kong',
  fields: ['title', 'text']
});
例2:文件必须包含任一术语 'donkey' 财务报告和审定财务报表 'kong'数字 :
pouch.search({
  query: 'donkey kong',
  fields: ['title', 'text'],
  mm: '50%'
});
例3:文件必须至少包含三个术语中的一个 'donkey', (中文(简体) ), 'kong',以及 'country'数字 :
pouch.search({
  query: 'donkey kong country',
  fields: ['title', 'text'],
  mm: '33%'
});
默认 mm 值为 100%。所有值必须按百分比提供(提示可以).
过滤文档
如果您只想要索引文档的子集, 您可以包含一个过滤函数, 它告诉我们要跳过哪些文档 。 过滤器函数应返回 true 要索引的文档,以及 false 您想要跳过的文件。 (真/虚值也行
示例
pouch.search({
  query: 'foo',
  fields: ['title', 'text'],
  filter: function (doc) {
    return doc.type === 'person'; // only index persons
  }
}).then(function (info) {
  // handle result
}).catch(function (err) {
  // handle error
});
这个 filter 选项,比如 fields 财务报告和审定财务报表 language,影响基础索引的特性,从而影响建筑和删除(见下文建筑/删除).
感谢 让-菲利克斯·吉拉德 执行这个功能!
构建索引
如果你只使用 search() 方法,那么您第一次查询会很慢,因为索引必须建立.
为了避免性能缓慢,您可以明确告诉搜索插件使用 {build: true}数字 :
pouch.search({
  fields: ['title', 'text'],
  build: true
}).then(function (info) {
  // if build was successful, info is {"ok": true}
}).catch(function (err) {
  // handle error
});
这将在不查询的情况下建立索引 。 如果数据库自您上次更新(例如添加了新的文档)以来已经改变,那么它将只是用新的文档来更新索引。 如果一切都没有改变,那它就不会做任何事情.
您至少必须提供 fields 您想要索引。 如果语言不是英语, 你必须通过在 language 选项。 布施无相.
删除索引
如果出于任何原因,你需要删除一个已保存到磁盘的索引,你可以通过 {destroy: true} 页:1 search() 它将删除外部搜索数据库.
pouch.search({
  fields: ['title', 'text'],
  destroy: true
});
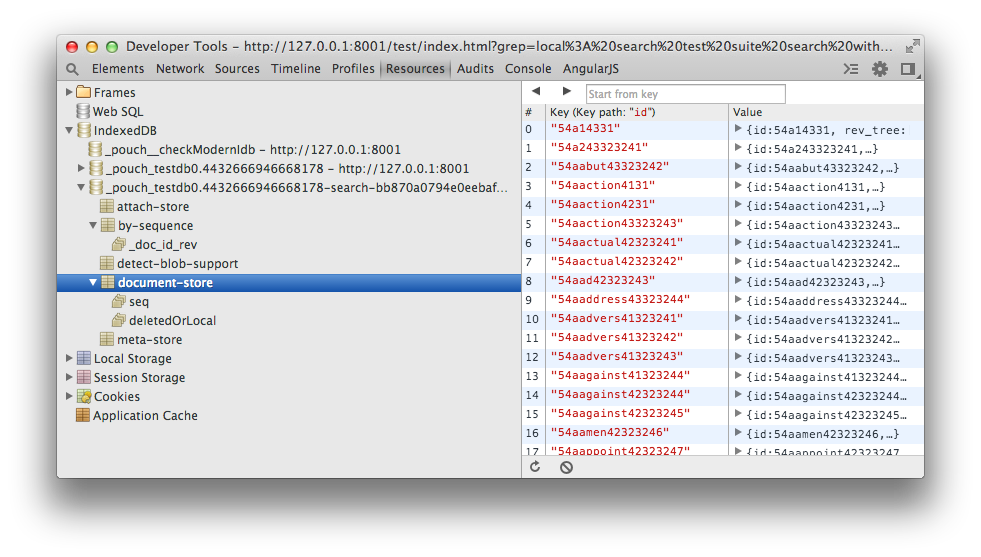
当你这样做,你 必须 至少提供 fields,因为外部数据库是根据要索引的字段创建和识别的。 你也应该提供 language 选项,如果语言不是英语。 I.e.,为每一个独特的 fields 要索引的组合(加) language 如果非英语,将特别为查询创建一个单独的数据库。 如果你打开你的开发工具,你可以看到它;它应该有一个名字像 <mydbname>-search-<md5sum> 看起来像这样:
系统查询
当你搜索时,a 持续地图/减少指数 以保存索引数据并提供尽可能快的查询.
这意味着你可以使用 stale 选项,如 query() API,为了获得更快但不太准确的结果:
// return immediately, update the index afterwards
pouch.search({
  query: 'donkey kong',
  fields: ['title', 'text'],
  stale: 'update_after'
});
或者说
//
pouch.search({
  query: 'donkey kong',
  fields: ['title', 'text'],
  stale: 'ok'
});
很可能,你不会想这样做 除非你的数据库经常改变.
其他语文
默认的Lunr输油管使用Porter起降管,该管为英语所优化. 例如,“工作”、“工作”、“工作”和“工作”等词,都会使用默认设置来决定同一个干线.
显然,其他语言有不同的形态(和句子),所以为了支持这些语言,这个插件可以与 语言 插件 .
要使用另一种语言,首先遵循 语言指导 安装您选择的语言.
下一个,使用 language 选项
pouch.search({
  query: 'marche',
  fields: ['text'],
  include_docs: true,
  language: 'fr'
});
回应:
{
  "rows": [
    {
       "doc": {
         "_id": "french-doc",
         "_rev": "1-997cba2d79a6f803c6040ddbedee642f",
         "text": "Ça va marcher."
       },
       "id": "french-doc",
       "score": 0.7071067811865475
    }
  ],
  "total_rows": 1
}
您仍可使用英语查询:
pouch.search({
  query: 'works',
  fields: ['text'],
  include_docs: true
});
回应:
{
  "rows": [
    {
      "doc": {
        "_id": "english-doc",
        "_rev": "1-48f9b2f4f17fc352fa53a21dca7e188e",
        "text": "This will work."
      },
      "id": "english-doc",
      "score": 1
    }
  ],
  "total_rows": 1
}
如果你没有指定一个 language,则默认值为 'en'在引擎盖下,将按语言创建单独的外部数据库(以及按语言和语言分类的外部数据库) fields 定义),所以如果你在使用 destroy 财务报告和审定财务报表 build 选项.
说明: 当前 lunr- 语言插件需要全局 lunr 对象,因此不幸的是,您必须在您的项目中将 lunr 列为额外的依赖,并将其分配到全局(如 lunr 语言指令所描述). 希望将来能解决.
多语种搜索
近来 lunr-languages 开发者同时增加了以多种语言搜索的能力. 要能够从几种语言搜索:
-
你应该包括
lunr.multi.js从lunr-languages仓库。 (目前只有主人可以使用;他们没有标记一个发布). -
将数组传递到
language,例如:
pouch.search({
  query: 'marche',
  fields: ['text'],
  include_docs: true,
  language: ['en', 'fr']
});
上述代码将使用法语和英语进行搜索.
自动建议和前缀搜索
虽然 pouchdb-quick-search 插件不提供前缀/ 自动建议支持, 您可以在 PouchDB 中通过使用 allDocs()。 。 。 .
只要创建与您想要搜索的相等的文档, 然后使用 startkey编号 :endkey 加特殊高单码字符 \uffff 要搜索 :
pouch.bulkDocs([
  {_id: 'marin'},
  {_id: 'mario'},
  {_id: 'marth'},
  {_id: 'mushroom'},
  {_id: 'zelda'}
]).then(function () {
  return pouch.allDocs({
    startkey: 'mar',
    endkey: 'mar\uffff'
  });
});
这将返回所有开始的文档 'mar',在这种情况下,这将是 'marin', (中文(简体) ), 'mario',以及 'marth'。 。 。 .
怎么会这样? 在PouchDB和CouchDB中 医生的身份证是 按语法分类因此 \uffff 诡计.
请注意,要处理大写/小写,您必须用 _ids 已小写,然后使用小写字母进行搜索.
说明: 您也可以使用 地图/减少查询,原则相同(包括 \uffff 骗局。 然而,业绩可能比 allDocs() 因为你使用的是二级指数而不是初级指数.
算法
此插件使用经典搜索技术 : TF-IDF (英语),这在精确度和速度之间达成了良好的平衡。 它可能是世界上部署最广泛的搜索算法.
此外,它还采用基于以下因素的每个外地加权法: 断开磁盘 所用的算法 Apache 溶剂,也就是说,相对于长的田地来说,短的田地倾向于被增强. 这对诸如网页标题和网页内容之类的事物很有用,其中标题中的单词通常比内容中的单词更重要. 对于多字查询,这种算法还具有偏好两个字相匹配的文档的优美效果,甚至跨越了多个字段.
关于指导这一执行的算法的更多信息,请参见: Lucene 相似性文档。 。 。 .
大楼
npm install
npm run build
测试
在节点
这将使用 LevelDB 运行节点测试 :
npm test
您也可以使用 :
npm run coverage
如果您不喜欢覆盖结果, 将值从 100 更改为其它 package.json,或添加 /*istanbul ignore */ 评论.
如果你在全球安装了Mocha,可以使用:
TEST_DB=local mocha --reporter spec --grep search_phrase
这个 TEST_DB 环境变量指定 PouchDB 应使用的数据库(见 package.json) (中文(简体) ).
在浏览器中
运行 npm run dev 然后指向您最喜欢的浏览器 http://127.0.0.1:8001/test/index.html (中文(简体) )。 。 。 .
查询参数 ?grep=mysearch 将搜索匹配的测试 mysearch。 。 。 .
自动浏览器测试
你可以运行例如.
CLIENT=selenium:firefox npm test
CLIENT=selenium:phantomjs npm test
这将自动运行测试,完成后进程会以0或1退出. Firefox使用索引DB,而PhantomJS使用WebSQL.