@ extractus/ article- extractor
从 URL 中提取主文章,主图像和元数据 .


安装
德诺
deno add jsr:@extractus/article-extractor
节点.js / Bun
pnpm add jsr:@extractus/article-extractor
# or
npx jsr add @extractus/article-extractor
# or
bunx jsr add @extractus/article-extractor
或者从 npm 安装 :
npm install @extractus/article-extractor
# or
bun add @extractus/article-extractor
使用量
import { extract } from "jsr:@extractus/article-extractor";

const data = await extract("https://example.com/article");
console.log(data);
APIs 密码
extract()
从 URL 或 HTML 字符串中装入并提取文章数据.
语法
extract(input: string): Promise<ArticleData | null>
extract(input: string, parserOptions?: ParserOptions): Promise<ArticleData | null>
extract(input: string, parserOptions?: ParserOptions, fetcher?: Fetcher): Promise<ArticleData | null>
示例
import { extract } from "jsr:@extractus/article-extractor";

try {
  const article = await extract("https://example.com/some-article");
  console.log(article);
} catch (err) {
  console.error(err);
}
结果是 null (当找不到文章时)或 ArticleData 对象 :
interface ArticleData {
  url?: string;           // best resolved URL
  links?: string[];       // alternative URLs (canonical, shortlink, amphtml)
  title?: string;         // article title
  description?: string;   // short description / excerpt
  image?: string;         // main image URL
  favicon?: string;       // site favicon URL
  author?: string;        // author name
  content?: string;       // extracted article HTML
  source?: string;        // original publisher domain
  published?: string;     // publication date string
  ttr?: number;           // estimated time to read (seconds), 0 = unknown
  type?: string;          // page type (e.g. "article")
}
参数
input 所需经费
URL 字符串或原始 HTML 内容.
parserOptions 选项
| 财产 | 类型 | 默认 | 说明 |
|---|---|---|---|
wordsPerMinute | number | 300 | 每分钟读取时间估计的单词 |
descriptionTruncateLen | number | 210 | 生成描述的最大字符 |
descriptionLengthThreshold | number | 180 | 要保留元描述的最小字符 |
contentLengthThreshold | number | 200 | 文章内容的最小字符 |
allowedTags | string[] | (语义/内容标记) | 要保持输出的 HTML 标记 |
allowedAttributes | Record<string, string[]> | (src, href, alt等) | 要保存的相加属性 |
allowedIframeDomains | string[] | (youtube, vimeo等 | Iframe src 允许域 |
const article = await extract(url, {
  descriptionLengthThreshold: 120,
  contentLengthThreshold: 500,
});
fetcher 选项
带有签名的自定义获取函数 (url: string) => Promise<Response>。 。 。 .
使用此功能来自定义 HTTP 行为: 代理,信头, TLS, 认证, 超时等.
默认为 globalThis.fetch。 。 。 .
德诺 (带有代理) :
import { extract } from "@extractus/article-extractor";

const client = Deno.createHttpClient({
  proxy: { url: "http://proxy.example.com:8080" },
});
const myFetcher = (url: string) => fetch(url, { client });

const result = await extract("https://example.com/some-article", {}, myFetcher);
节点.js (通过undici使用代理) :
import { extract } from "@extractus/article-extractor";
import { fetch, ProxyAgent } from "undici";

const dispatcher = new ProxyAgent("http://proxy.example.com:8080");
const myFetcher = (url: string) => fetch(url, { dispatcher });

const result = await extract("https://example.com/some-article", {}, myFetcher);
阿宝 (带有代理) :
import { extract } from "@extractus/article-extractor";

const myFetcher = (url: string) =>
  fetch(url, {
    proxy: "http://proxy.example.com:8080",
  });

const result = await extract("https://example.com/some-article", {}, myFetcher);
自定义信头数字 :
const myFetcher = (url: string) =>
  fetch(url, {
    headers: {
      "user-agent": "MyBot/1.0",
      authorization: "Bearer token123",
    },
  });

const result = await extract("https://example.com/some-article", {}, myFetcher);
请求超时数字 :
const myFetcher = (url: string) =>
  fetch(url, {
    signal: AbortSignal.timeout(5000),
  });

const result = await extract("https://example.com/some-article", {}, myFetcher);
extractFromHtml()
从 HTML 字符串直接提取文章数据 .
语法
extractFromHtml(html: string): Promise<ArticleData | null>
extractFromHtml(html: string, url?: string): Promise<ArticleData | null>
extractFromHtml(html: string, url?: string, parserOptions?: ParserOptions): Promise<ArticleData | null>
示例
import { extractFromHtml } from "jsr:@extractus/article-extractor";

const res = await fetch(url);
const html = await res.text();

const article = await extractFromHtml(html, url);
参数
html 所需经费
包含文章的 HTML 字符串 .
url 选项
用于解析相对链接的源 URL.
parserOptions 选项
见 解析选项 见上文.
转换
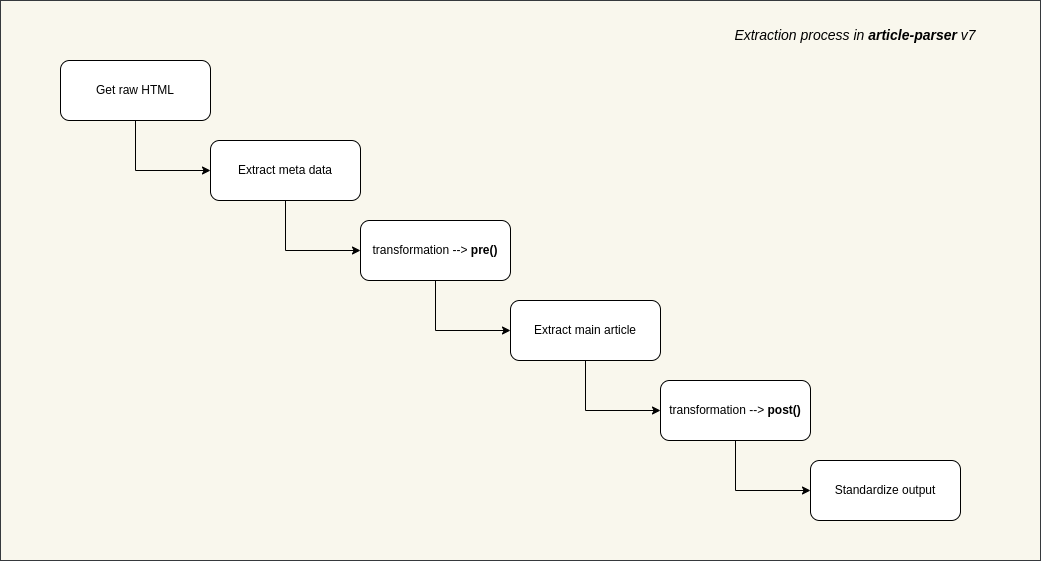
有时默认提取算法可能效果不佳. 变换让您每个站点加入前/后处理.
addTransformations(transformation: Transformation | Transformation[]): numberremoveTransformations(patterns?: RegExp[]): number
Transformation 对象
interface Transformation {
  patterns: RegExp[];                        // URL patterns to match
  pre?: (document: Document) => Document;    // pre-process raw HTML
  post?: (document: Document) => Document;   // post-process extracted article
}
对于匹配的 URL
patterns运行pre,取出文章,然后运行post在结果.
示例
import { addTransformations } from "jsr:@extractus/article-extractor";

addTransformations({
  patterns: [/([\w]+.)?domain\.tld\/*/],
  pre: (document) => {
    document.querySelectorAll(".advertise-area").forEach((el) => {
      el.parentNode?.removeChild(el);
    });
    return document;
  },
  post: (document) => {
    document.querySelectorAll("h4").forEach((el) => {
      const h2 = document.createElement("h2");
      h2.innerHTML = el.innerHTML;
      el.parentNode?.replaceChild(h2, el);
    });
    return document;
  },
});
要写更好的转换,请参考 链接 编辑 API 文档。 。 。 .
addTransformations(transformation | Transformation[])
添加单个或多个变换. 无转换 patterns 被忽略.
import { addTransformations } from "jsr:@extractus/article-extractor";

addTransformations([
  {
    patterns: [/([\w]+.)?abc\.tld\/*/],
    pre: (doc) => { /* ... */ return doc; },
    post: (doc) => { /* ... */ return doc; },
  },
  {
    patterns: [/([\w]+.)?xyz\.tld\/*/],
    post: (doc) => { /* ... */ return doc; },
  },
]);
removeTransformations(patterns?: RegExp[])
删除匹配给定模式的转换 。 调用无参数删除全部 .
import { removeTransformations } from "jsr:@extractus/article-extractor";

removeTransformations([
  /([\w]+.)?abc\.tld\/*/,
  /([\w]+.)?xyz\.tld\/*/,
]);
优先权顺序
当多个转换相匹配时,它们都按顺序执行.
鉴于两个匹配的转换 goo.gl数字 :
pre_one -> pre_three -> extraction -> post_two -> post_four
内容消毒选项
取出HTML使用内置的DOM树行走器进行消毒. 被丢弃的标签被取出(没有被丢弃),被丢弃的属性被取出. 通过 parserOptions数字 :
import { extract } from "jsr:@extractus/article-extractor";

// allow class attributes on <code> and <div>
const article = await extract(url, {
  allowedAttributes: {
    a: ["href", "target", "title"],
    img: ["src", "srcset", "alt", "title"],
    code: ["class"],
    div: ["class"],
  },
});
查看全部默认值,参见 src/config.ts。 。 。 .
发展
git clone https://github.com/extractus/article-extractor.git
cd article-extractor

# run tests
deno test --allow-all

# lint
deno lint

# build npm package
deno run -A ./scripts/build_npm.ts
许可证
《麻省理工学院许可证》
支持项目
这个项目是我空余时间维持的 如果你认为这有帮助, 有一些简单的方式支持它的持续发展:
- 来帮助更多的人发现它.
- 给我买杯咖啡: https://paypal.me/ndaidong (英语)
- 订阅 第 二 条 提取服务 在快速API上.
每一点支持都有助于保持该项目的积极维持。 谢谢