@fffangchenghao/dsh-web-search
给 DeepSeek Harness 加一双「自己上网」的手:模型不用你贴链接,就能先搜索、再打开网页读正文。




为什么选这个
- 不要 API key,八个引擎。 AnySearch、必应中国、DuckDuckGo HTML、必应国际、DuckDuckGo Lite、360 搜索直接抓取;Exa 走它的免密钥 MCP 通道加入主引擎,Firecrawl 的搜索 API 作为实测后的兜底。装好就能用。
- 官方发布事实优先。 PostgreSQL、Rust 和显式 npm 包查询会并行做一次窄查询;
Rust 1.90 发布说明的第 1 条是 Rust Blog 官方公告。查询上限 2.5 秒,失败就保留普通结果。 - arXiv 是一等科研源。 显式包含 arXiv 的论文/综述查询会并行走 arXiv 自己的 API,用布尔词而不是松散关键词,所以「RAG survey」返回的是综述而不是偶然提及。arXiv 的
/pdf/链接会改读 HTML 全文,不再被当成二进制拒绝;摘要页即使被命名为footer的站点外层包住,也能正常提取。 - 尾部有预算,配额不粉饰。 交互搜索在两个独立引擎返回后提前释放,拉丁文查询 5 秒、中文查询 3 秒封顶。Firecrawl 仍是兜底;需要稳定配额可以配
firecrawlApiKey,但免 key 的服务端配额不是客户端能修好的。 - 排序是量出来的,不是写出来的。 跨引擎 RRF 融合,叠加权威度与时效加权;20 条离线基准 + 81 组参数扫描,是这类插件里少数同时公开指标、逐条输出和置信区间的。方法见 排序是怎么做的。
- 一个包,两种运行时。 DSH 里是原生插件和唯一的
web_tools入口;Claude Code、Codex 等 MCP 客户端通过零依赖的 stdio server 使用同一套免密钥搜索,提供search、fetch、research、domain_search。见 跨 Agent MCP。 - 公开测量,也公开输的地方。 30 条中英查询对比记录可用性、延迟、独立域名、官方域名命中与每一条失败;对比对象是免 key Firecrawl 和匿名 Exa。这里 Exa 更快,本插件返回的独立域名更多;两条对比路径都未使用 key。方法和原始结果在 docs/comparison.md;Exa 架构差异、中文 3 秒预算和 Rust 官方源见 延迟与官方源。
- 抓取会承认失败。 二进制文档和「200 但正文为空」会被明确拒绝(
SEARCH_UNSUPPORTED、SEARCH_EMPTY),而不是当噪音返回;arXiv 的 PDF 链接是有意保留的例外,会改读 HTML 全文;direct → tunnel → render → extract 四级阶梯共享 25 秒预算,预算不足就不再起新的一级。预算是「每次请求」而不是「插件启动时」,这点有回归测试守着。 - Windows 是一等宿主。 纯 ESM,没有原生扩展或安装脚本;会自动读取 Windows 的 Internet 设置代理,完整测试套件也在
windows-latestCI 上跑通。安装见Windows 小节。 - 56 个测试文件、690 个用例,
lib/产物入库,声明了engines.dsh/engines.node,SECURITY.md 逐项列出插件会碰的进程、主机和文件。 - 双语文档。 本文件和 English README 同步维护。
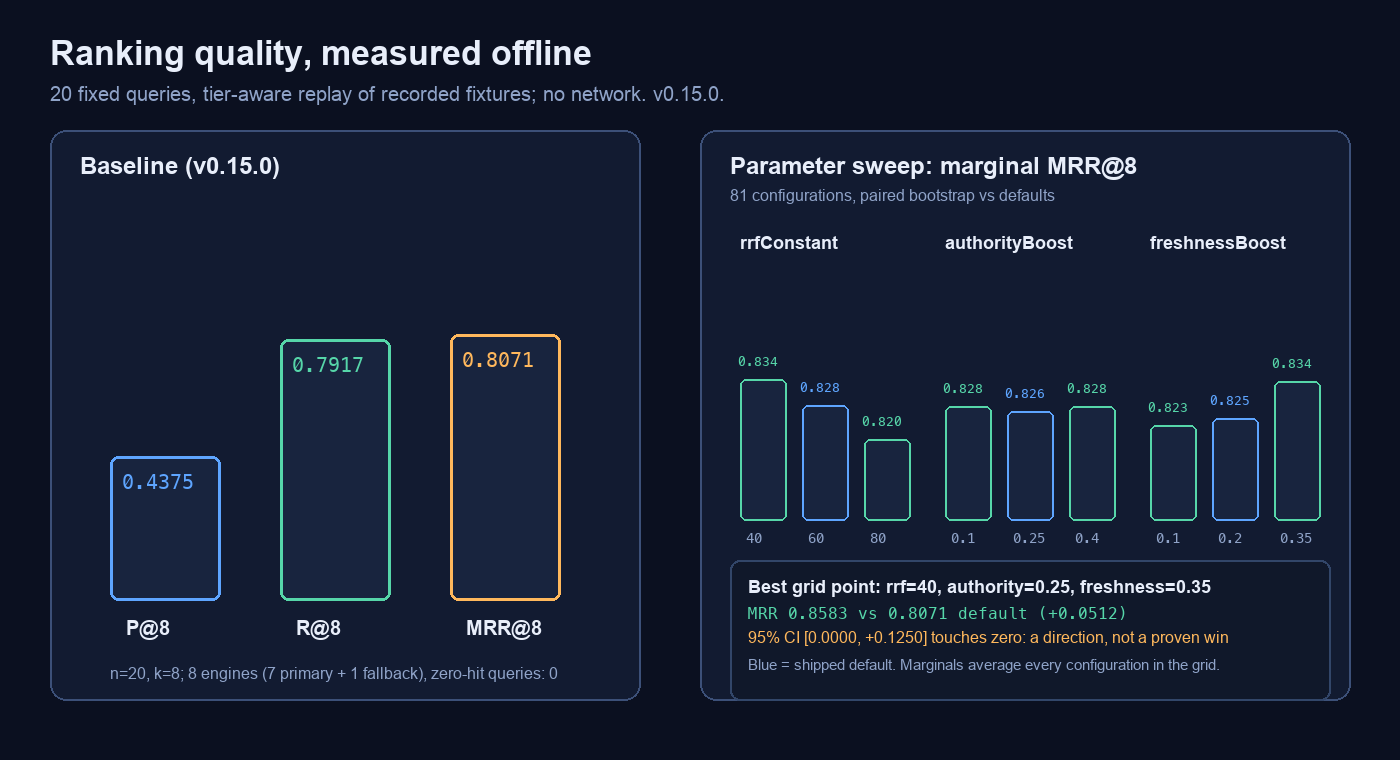
基准是离线、可复现的:20 条录制的查询,precision/recall/MRR@8,按语言、按类别、逐条输出,回归问题藏不进平均值里。运行 node scripts/bench.mjs 就能复现这张图。
它在同类里的位置
DSH 插件生态里的「联网搜索」已经很挤。下面是一张 2026-10-25 的历史快照 (stars 和 npm 下载量是采用度信号,不是质量分数):
| | 本插件 | dsh-free-search | dsh-web-search-pro | modsearch | anysearch-dsh |
|---|---|---|---|---|---|---|
| 免 key 路径 | 8 个引擎,全部免 key | ~30 个免费/付费引擎链 | 默认 5 个(seam、Exa、DDG、Bing、Jina) | Firecrawl + Keenable 免 key 默认 | 1 个 AnySearch 匿名 API |
| 专门数据源 | 34 个(默认开 8 个) | 41 个 | 平台注册表,不是垂直源目录 | 网页 + X,无垂直源目录 | AnySearch 的垂直 API |
| 面向模型的工具 | 1 个(web_tools,8 个 action)+ 4 个 MCP 工具 | ~10 个 | 2 个(web_index / web_call,20 个动作) | 原生搜索/抓取 + skill | 5 个 |
| 测试 | 56 文件 / 690 用例,本地实测 | package.json 无测试脚本 | 774 单元 + 94 bench,自报 | 配了 Vitest,未公布数量 | 配了 Vitest,未公布数量 |
| GitHub stars | 0 | 620 | 77 | 836 | 663 |
| npm 近一月下载 | 1,087 | 52,436 | 6,420 | 43,151 | 9,251 |
| npm 解包大小 | 1.2 MB | 0.70 MB | 3.05 MB | 0.51 MB | 0.27 MB |
这不是「只有一个冠军」的排行榜,比较诚实的结论是:
- 功能深度:中上。
dsh-free-search引擎和垂直源更多;dsh-web-search-pro的证据/排序管线和平台后端更深;modsearch的跨宿主 能力更强。 - 工程质量与可验证性:接近第一梯队。 690 个本地测试、可重放的排序基准、 明确的安全边界、只有 1 个运行时依赖,同时体积远小于 Playwright 重型方案。
- 免 key + 官方源纠错:最强卖点。 Chrome、PostgreSQL、AI Act 的官方路径 和 34 个垂直源,不是其他插件普遍具备的。
- 采用度与成熟度:这个样本里的后段。 2026-10-25 快照时 GitHub 仓库刚创建 4 天、0 stars,还缺少独立采用;当前 npm 版本是 0.24.2。
- 工具面的经济性:现在有竞争力。 0.20.x 只暴露一个
web_tools+ 8 个 action,接近dsh-web-search-pro的 2 工具 + 20 动作;旧的八个工具名保留为 可选兼容模式。
要最大安装量和引擎广度,优先看 dsh-free-search 或 modsearch;要最深的
证据/评分管线和浏览器平台,看 dsh-web-search-pro。本插件是「完全免 key、
搜索 + 垂直查询 + 研究包 + 官方源纠错」的轻量选项。它不是最流行的,也不该
自称最大。
最新版本与安装命令以 npm 上的 latest 为准;上面的对比表是历史快照,不是实时排行榜。下面先讲「它跟我有什么关系」,技术细节放在后面的附录。
一句话说明
装好这个插件,你在对话里问「上周发布的那版怎么配置」,模型可以自己调用 web_search 去公开搜索引擎查,拿回排好序的标题、链接和摘要;摘要不够用时,它还能调用 web_fetch 打开其中一条链接,把网页正文整理成 Markdown 读进对话,而不是一整屏 HTML。如果一个问题需要分别查几件事,它可以调用 search_many,一次拿回每条查询各自的结果;如果只想给一条查询临时加时间窗,可以调用 advanced_search。如果问题问的是某个 npm 包、GitHub 仓库、论文或问答帖,它还可以调用 domain_search,直接去那几类专门的数据源里查。如果问题落在 B 站、V2EX、Reddit、YouTube、知乎或掘金,它可以调用 platform_search;PostgreSQL 版本/EOL 问题会先补上项目官方支持表,而不是只信旧新闻稿;如果一页正文长到一次读不完,它还可以调用 read_page,从上次停下的地方接着读。
对你的实际影响就三条:
- 问题里带「搜一下」「最新」「官网」「文档」时,模型真的有机会去查,而不是回你一句「我的知识截止到某年」。
- 问包、仓库、论文、问答时,模型能直接查对应的数据源,不用拿网页搜索去碰运气。
- 你不需要准备搜索 API key,也不需要为搜索单独付费。
说白了就一句话:它给 Harness 的 web 服务插上两个「提供方」——搜索用 bing,抓网页用 http-proxy;再给模型加一个 web_tools action 工具:action: "domain_search" 专查包、代码仓库、论文、问答和百科,search_many 一次跑多条查询,advanced_search 给单条查询临时加时间窗,read_page 把长页面分段接着读,research 把几次搜索变成一份带引用的证据包,platform_search 查 B 站、V2EX、Reddit、YouTube、知乎和掘金,cache_search 在 research 已抓取的全文里二次检索,engine_test 用来逐个检查引擎是否健康。八种能力只占一个工具注册,不是八个独立插件,也不是八个常驻工具。
它解决什么问题
一个很常见的场景
你刚把一个库升到新版本,配置文件里某个字段改了名。你问模型:
「v1.2 之后
timeout是不是改成timeoutMs了?帮我确认下官方文档。」
没有这个插件时,模型只有三种反应:
- 凭训练时记住的旧文档回答,可能对,也可能一本正经地错;
- 说「我无法访问互联网,建议你查官方文档」;
- 直接报错——如果用的是 Harness 自带的搜索后端(
deepseek-official),它需要 DeepSeek 的凭据才能工作,没有凭据时web_search会直接失败。
有了这个插件之后:
- 模型调用
web_search,插件同时问几家搜索引擎,把重复的网址去掉,按「是不是多家都排得靠前、是不是官方文档、是否够新」重新排序,返回 8 条左右的候选(开了时间过滤会少一些,只留窗口内的); - 模型看到某条是
kubernetes.io的文档,调用web_fetch把这一页的正文读回来; - 它拿着正文回答你,还能顺手把链接给你。
前后对比
| 场景 | 没有它 | 有它 |
|---|---|---|
| 问最近几周才发布的东西 | 只能靠记忆,容易过时 | 现搜现读,能给出处 |
| 你扔给它一条链接说「读一下」 | 直连超时(如 github.com)就失败 | 先直连,再走本地代理;自己装了 Playwright 还能交给浏览器渲染,最后才是 AnySearch 抽取正文 |
| 搜索结果来源 | 单一后端,取决于凭据 | 最多六个来源交叉验证,去重后排序 |
| 中文提问 | 容易返回词典页、百科页 | 中文问题优先用中文来源,英文文档也不会被挤掉 |
| 问某个 npm 包、仓库或论文 | 只能拿网页搜索碰,常搜到二手介绍页 | domain_search 直接查对应数据源,拿到包名、仓库或论文条目 |
| 被搜索引擎限流 | 每次都失败,每次都重试 | 让这家先歇 5–30 分钟,其余照常工作 |
它不解决什么
它不会让模型变聪明,也不会替你做判断。它只是把「查」和「读」这两件事接上了。搜到的内容仍然可能不准、可能过期,模型仍可能理解错——这一点和你自己用搜索引擎没有本质区别。
概念科普
这一节解释后面会用到的词。每个词三五句话,配一个类比,不需要任何技术背景。
大模型,以及它为什么会「不知道」
大模型(就是 ChatGPT、DeepSeek 背后那类 AI)是把海量文字读完之后,学会「下一个词最可能是什么」的程序。它记住的是训练那一刻之前的内容,这个时间点叫知识截止(knowledge cutoff)。
它本身不联网。你问它昨天发生的事,它不是「查了没查到」,而是根本没有这个信息的入口。类比:一位读遍图书馆、但三年前就搬进山里不再收快递的学者——问他三年前的事很靠谱,问他上周的新闻,他只能凭推理猜。
Agent(智能体),以及它为什么需要「工具」
Agent 就是「会自己决定下一步做什么」的 AI。普通聊天是问一句答一句;Agent 会先想「我该不该查一下」,再决定调用哪个工具,看到结果后继续想下一步。
工具(tool)是给 Agent 用的固定功能,比如「搜索」「读取网页」「执行命令」。模型不能自己上网,但它可以请求 Harness:「帮我跑一下 web_search,参数是这些」。Harness 跑完,把结果塞回对话,模型再继续。类比:你不是让厨师亲自去菜市场,而是给他一个电话,让他打给采购。
web_search 和 web_fetch 的区别
这是最容易混的一对。它们解决的是两个不同的问题:
web_search:找网址。 你给关键词,它给一张清单,每条有标题、链接、一两句摘要。web_fetch:读正文。 你给一个具体网址,它把那一页的正文抓回来,并整理成可读的 Markdown。
web_search | web_fetch | |
|---|---|---|
| 你给它什么 | 一句话关键词 | 一个具体网址(http:// 或 https://) |
| 它给你什么 | 默认 8 条左右的候选:标题 + 链接 + 摘要(开了时间过滤则只留窗口内的) | 那一页的正文,整理成 Markdown(或纯文本) |
| 能不能直接回答你 | 只能看摘要,常常不够 | 能,正文就在里面 |
| 什么时候用 | 不知道去哪找、要比较多个来源 | 已经知道该读哪一页 |
| 走哪个提供方 | bing(本插件) | http-proxy(本插件) |
| 典型耗时 | 1.4–3.8 秒(有缓存时几乎瞬间) | 取决于站点,直连最多等 5 秒再换路子 |
生活化的说法:
search 像图书管理员给你一张书单:书名、书架号、一句话简介,三十秒就能拿到。但书单不是书,简介也可能写得不准。
fetch 像你按书架号把书借回来、翻到正文:内容全了,但可能被人借走(网站拒绝访问)、可能是一本需要会员才能看的书(付费墙),也可能目录写错了(链接 404)。
所以两个要配合:先 search 拿到书单,再 fetch 挑中的那本。只 search 不 fetch,模型看到的永远是简介;只 fetch 不 search,模型得先知道网址——而它往往不知道。
fetch 拿回来的则是正文,不是页面的装修:导航、广告、脚本、页脚、表单都会被剔掉,标题、列表、代码和表格以 Markdown 形式留着。
专用检索(domain_search):查的不是网页,是数据源
web_search 问的是「公开网页上有什么」。domain_search 问的是更窄的一件事:「这个包存在吗、这个仓库还维护吗、有没有这篇论文、这个问题有人答过吗」。
它直接问 34 家公开数据源,其中 8 家默认开启:GitHub、npm、PyPI、arXiv、Wikipedia、Hacker News、Stack Exchange、crates.io。另外 26 家——GitLab、Codeberg、Docker Hub、Maven、NuGet、RubyGems、Packagist、pub.dev、Hugging Face 模型与数据集、Open VSX、Terraform 模块与 provider、WordPress、JetBrains、OpenAlex、Crossref、Europe PMC、UniProt、ClinicalTrials.gov、NVD、CoinGecko、Internet Archive、Wikidata、Nominatim——通过 sources 参数按需开启。每家都提供不用密钥的公开接口,拿回的是结构化条目(标题、链接、摘要),而不是一张搜索结果页。
类比:web_search 像在街上问路人「这附近哪有五金店」,得到的是各种指路;domain_search 像直接走到五金店柜台报型号——问对了店,回答就干脆。
web_search | domain_search | |
|---|---|---|
| 适合问什么 | 概念、新闻、官网、教程 | 包、代码仓库、论文、问答、百科条目 |
| 数据从哪来 | 公开搜索引擎的结果页 | 八家数据源各自的公开接口 |
| 一次给几条 | 默认 8 条,跨来源去重排序 | 每个源默认 5 条,按来源交错排 |
| 要不要 key | 不要 | 不要 |
| 失败时 | 报错列出每家的原因 | 单源失败只进 failures,其余照常 |
两个一起用最顺:先用 domain_search 找到包或论文,再用 web_fetch 打开它的主页或 README 读细节。
旁边还有六个帮手:search_many、advanced_search、read_page、research、platform_search 和 cache_search。当一个问题需要分别查好几件事——比如每个候选库各查一次——search_many 一次接住 1–5 条查询,把每条查询的结果分开返回,某一条失败也不会拖垮整批;只有一条问题需要「最近一周」时,advanced_search 只给这一次调用加时间窗;read_page 则在网页长到一次抓不完时,接着上一次的位置继续往下读;research 则在摘要不够、又必须决定该信哪一页时,先跑最多三条查询,再打开靠前的页面,返回一份每个摘录都带出处的证据包。
分段读长页(read_page):一次读不完,就接着读
web_fetch 有两个天生限制:一次只抓一页,而且超过 fetchMaxLength(默认 20000 字符)的部分会被截掉。截掉的尾巴不是「读得慢」,是根本没有下半段——宿主的抓取请求只有 url 一个字段(WebFetchRequest = { url }),没有 offset、没有 maxLength,所以宿主工具自己没法从中间接着读。
插件因此自己注册了一个工具 read_page,把这个缺口补上。它和 web_fetch 走同一套抓取梯队,但多了一个 offset:
| 参数 | 必填 | 默认 | 意思 |
|---|---|---|---|
url | 是 | — | 要读的绝对地址,只接受 http / https |
offset | 否 | 0 | 从第几个字符开始返回,零起始 |
maxLength | 否 | 设置里的 fetchMaxLength | 这一段最多返回多少字符,1000–200000 |
format | 否 | 设置里的 fetchFormat | markdown 保留标题、列表、表格和链接;text 只留文字 |
用法就一句话:第一次 offset=0,看结果里的 nextOffset,把它原样传给下一次的 offset,直到 nextOffset 为 null,整页就读完了。每次返回的 content 只是这一段正文;「还剩多少字符、下次用哪个 offset」那行提示由工具单独生成,不算在 content 里,所以把所有段的 content 拼起来,就是逐字符不差的完整正文。
同一页、同一格式的正文会缓存在插件里(最多 8 页,按最久未用淘汰),所以接着读不会每段重新下载整页:第一次抓取之后,后面的段落直接从内存里切片。内部那一次抓取也不按 fetchMaxLength 截断;转换后的正文另有 2,000,000 字符的硬上限保护。
边界行为:
offset超过整页长度会直接报错;offset正好等于长度算「已经读完」,返回空内容与nextOffset: null;truncated描述的是来源:整页超过 2,000,000 字符(或传输层截断)时才为true,它不代表「还有下一段」——还有没有,看nextOffset;- 抓取失败(网络、HTTP 状态、被拦)会以结构化的
failures返回,不会把整次工具调用弄挂。
实测 https://docs.python.org/3/library/asyncio-task.html:用 offset=0 和 nextOffset 连续读,拼起来与一次性抓取的完整正文逐字符相等(真实联网,1.3 秒)。
DeepSeek message 和会话(session)
模型本身没有记忆。每次请求,Harness 都会把整串消息重新发给它:系统提示、你之前说的话、模型之前的回答,以及工具的结果。这一串就叫 messages;一次连续的对话存在一个 session(会话)里。
一次工具调用的往返长这样:
- 模型说「我要调
web_search,query 是 xxx」——这是一条 assistant 消息,里面带 tool call; - Harness 真的去搜,把结果作为一条 tool result 消息追加到消息列表;
- 下一次请求,模型看到的是「用户问题 + 自己的工具请求 + 搜索结果」这一整串,于是接着回答。
类比:点菜。你点单,服务员把单子递进厨房,做好的菜作为新的一盘端回桌上。模型每次看到的都是「桌上现有的所有盘子」,而不是只看到最后端上来的那盘。这也解释了一个常见现象:搜索结果太长会占地方——它占的是模型的上下文,也就是桌子的面积。
provider(提供方)
Harness 里有个叫 web 的服务,它自己不会搜索,只负责「把请求转给某个提供方」。提供方(provider)就是真正干活的那个实现。
类比:墙上的插座是 web 服务,插件是插头。你换插头,墙不用动,电器也不用换。这个插件插了两个插头:
- 搜索插头,id 叫
bing,由配置里的searchProvider: bing选中; - 抓网页插头,id 叫
http-proxy,由fetchProvider: http-proxy选中。
换掉它能改变什么?比如换回官方的 deepseek-official,web_search 就又需要 DeepSeek 凭据;换成别的抓取实现,web_fetch 的超时和代理策略就跟着变。工具名不变,工具背后的手艺变了。
插件和插件包(bundle)
插件是一段装进 Harness 的代码。插件包(bundle)是它的打包形式:一个 npm 包,里面除了代码,还带一份 cordis.patch.yml,告诉 Harness「启动时把我这行配置插进去」。
装在哪里?装在你当前 profile 的依赖里。profile 可以理解成「一套独立的 Harness 配置」——本机就有 desktop、web、headless 几套。插件代码、以及你在 profile 的 cordis.patch.yml 里写的配置,共同决定它怎么跑。
为什么改代码要重启?因为 Node.js 的模块在一个进程里只加载一次,正在运行的 Harness 手里是启动那一刻的旧代码。类比:换灯泡得先关灯再开,热插拔不会亮。在设置页保存不用重启(例外情况和缓存的影响见「设置页怎么用」),但改 src/*.ts 一定得重新构建并重启。
顺手解释几个会碰到的词
- 引擎(engine):一个具体的搜索来源,比如 Bing 中国站、360、DuckDuckGo。它返回的是一张网页,不是一个标准接口。
- 抓取与解析(scrape / parse):把网页下载下来,再从 HTML 里把标题、链接、摘要抠出来。上游一改版,抠法就可能失效。
- 代理 / 隧道(proxy / tunnel):让请求先经过一个本地程序(比如 Clash)再出网。有些站点直连不通,走它才通。
- 缓存(cache):把刚搜过的结果记十分钟。同一个问题再问一次,直接拿记录,不再打扰搜索引擎。
- 限流与冷却(rate limit / cooldown):搜索引擎不喜欢短时间大量自动请求,会回一个验证页。插件会让这家「歇一会儿」,默认 5 分钟起,最多 30 分钟。
- RRF 排序:一种把多家搜索结果的排名「投票合并」的算法。某条结果在几家都排前面,就往上提;只有一家说好,说服力就弱一些。
- API key:访问某个服务要出示的通行证。这个插件默认不需要;AnySearch 的 key 是可选的,填了额度更高。
能力清单
每条都是「人话 + 技术补充」。技术补充可以跳过,不影响使用。
-
同时问好几家搜索引擎。 主力三家一起查(AnySearch、DuckDuckGo HTML、Bing 中国站);如果三家一条都没给,再让 Bing 国际站、360 和 DuckDuckGo Lite 兜底。一共六个来源。 技术补充:
HOSTS里tier: primary/fallback两档;360 因验证码墙降为fallback;viaProxy的三家(ddg-html、www.bing、ddg-lite)只在检测到代理时参与。 -
完全不需要 API key。 AnySearch 匿名就能用,国内引擎和 DuckDuckGo 都是抓公开结果页,不需要注册。 技术补充:AnySearch 走
POST https://api.anysearch.com/v1/search,max_results固定 10;抓取型引擎会校验页面里有没有回显查询词,防止把「热门推荐」当成你的结果。 -
重复的网址只留一条。 同一个页面被三家返回,也只出现一次,并且位置会更靠前。 技术补充:按 URL 去重,忽略
www.和末尾斜杠;RRF 里votes统计「多少个不同引擎返回过它」。 -
排序不只看排名,还看「是不是官方」和「够不够新」。
kubernetes.io、developer.mozilla.org、rfc-editor.org这类域名会被加权;30 天内发布的内容也会被加权。 技术补充:score = votes / (rrfConstant + position),再乘1 + authorityBoost和新鲜度系数;默认rrfConstant: 60、authorityBoost: 0.25、freshnessBoost: 0.2、freshnessDays: 30。发布日期由各引擎的结果解析而来,所以新鲜度这一项现在按真实日期计算,不再空转。 -
中英文分开处理,而且中文结果必须真的在讲这个问题。 英文问题先看国外来源,中文问题先看中文来源,避免「how to …」被某个中文引擎按单词
how匹配成词典页。中文长查询仍可能被引擎退化成单字词典页、公司页;这些行在融合前会被丢掉,除非标题/摘要/URL 与问题至少重合两个词;.gov.cn/.edu.cn官方页面另有权威度加权。 技术补充:查询含 CJK 字符时lead = cn,纯 ASCII 时lead = global;非主导区只在主导区凑不够条数时才追加。src/relevance.ts把中文查询切成二字 bigram(ASCII 单词权重翻倍),要求与标题、摘要或 URL 至少两个权重单位的重合;英文查询原样放行。对整串匹配型引擎还会用核心词补问一次(src/variants.ts),但只在原答案没有任何一条能通过相关性门槛时才补问——短查询正常工作时不付这次请求和延迟:「东数西算 八个国家枢纽节点 定位」会补问「东数西算」,「如何配置 postgres 逻辑复制」会补问「postgres 逻辑复制」。实测第一条查询:cn.bing原来返回十条词典/公司页,现在能贡献发改委和 gov.cn 文章,融合结果八条全部相关。 -
快慢可以选。 默认
auto:英文最多等 5 秒、中文最多等 3 秒;fast谁先回就用谁;all等所有引擎,最多 10 秒。 技术补充:wait三值,软截止分别是auto5000/3000 ms、fast3500 ms、all10000 ms;单引擎硬超时默认timeoutMs: 15000。 -
同一个问题不重复打扰搜索引擎。 十分钟内问同一个问题,直接用上次的结果,几乎瞬间返回。 技术补充:TTL + LRU 缓存,
cacheTtlMs: 600000(10 分钟)、cacheEntries: 100;键是lead|wait|limit|排序后的引擎 id|时间窗|策略字段|归一化 query,其中时间窗只在非off时出现、策略字段只在非默认时出现,所以默认检索的缓存行为没变。 -
被限流会自己歇一会儿。 某家回了验证页,就先不用它,过几分钟再试,其他家照常。 技术补充:
baseCooldownMs: 300000起,按连续失败次数翻倍,上限maxCooldownMs: 1800000;对方给了Retry-After就听对方的;解析失败和主动取消不冷却。 -
能把网页正文读回来。 搜索给链接,
web_fetch给可读的正文;直连不通时自动换路。 技术补充:四级梯队——直连(最多 5 秒)→ 本地隧道 → 浏览器渲染(可选,自己装了 Playwright 才启用)→ AnySearch 抽取(需要 key);原始响应体最多保留 1 MiB(1048576字节),随后转换(见第 10 条)并按fetchMaxLength截断。 -
抓回来的是整理好的 Markdown,不是原始 HTML。 导航、脚本、页脚、表单会被剔掉;标题、段落、列表、代码块、引用、链接、图片和表格保留,表格转成 Markdown 表格。超过默认 20000 字符的页面,末尾只有一行提示,写明原始长度。 技术补充:
fetchFormat(默认markdown,可改text)与fetchMaxLength(默认20000,范围 1000–200000)。实测docs.python.org/3/library/urllib.parse.html:119,614 字符的原始 HTML 转成 40,891 字符的正文 Markdown,工具实际返回 20,080 字符 + 一行截断提示。正文按<article>→<main>/role=main→ 文本最密的容器依次选取;相对链接会补成绝对地址。web_fetch本身不能续读:宿主的WebFetchRequest只有url一个字段,没有 offset、maxLength、format,所以它只能从头读起;要接着读下半段,用read_page(下一条)。 -
一次读不完的长页面,可以分段接着读。 网页超过
fetchMaxLength时,web_fetch只能给前半段;换成read_page,用nextOffset一段一段接着读,直到读完整页。 技术补充:read_page是插件自己注册的工具(宿主的WebFetchRequest只有url,所以宿主工具无法续读),参数url(必填)、offset(默认 0)、maxLength(默认取fetchMaxLength,1000–200000)、format(markdown/text,默认取fetchFormat);返回url、content、offset、nextOffset(读完为null)、totalLength、truncated、chunk、failures。内部一次抓取不按fetchMaxLength截断(整页硬上限 2,000,000 字符),再按 offset 切片,所以续读不会重新下载整页;同一 URL、同一格式的正文缓存在插件里(8 页,LRU)。offset超过totalLength报错,offset === totalLength视为读完;非 http/https 报错;抓取失败走failures。名字被占用时注册为web_read_page;宿主没有ctx.tools时不注册。实测docs.python.org/3/library/asyncio-task.html:分段拼接与一次性正文逐字符相等(联网,1.3 秒)。 -
页面只给了个壳时,可以交给真浏览器渲染。 有些页面的 HTML 里只有一个标题和加载脚本,正文要等浏览器把 JavaScript 跑完才出现。装了 Playwright 之后,插件可以自己开一个无头 Chromium,把页面渲染完再读。 技术补充:插件不打包 Playwright,也不把它写进依赖;运行时依次尝试
import('playwright')、import('playwright-core'),两个都没装就静默跳过,原因写进结果的render字段,绝不报错。梯队顺序是直连 → 本地隧道 → 浏览器渲染 → AnySearch 抽取;浏览器在本机执行,不要密钥,也不把网址交给第三方,所以排在抽取之前。renderJs三值:auto(默认,只在疑似壳页面时渲染)/always(每次都用浏览器)/off(禁用);renderTimeoutMs默认15000毫秒(1000–120000)。「疑似壳页面」的判定:正文可读字符为 0;或页面是 403/429 但还有内容;或可读字符少于 500;或少于 1200 且带__NEXT_DATA__、id="root"、__NUXT__、ng-version这类前端框架标记;404 和其他 5xx 不渲染。渲染失败、超时或被中止时,返回前一级梯队已经抓到的内容,整次抓取不会因此失败。安装:npm i -g playwright && npx playwright install chromium(或项目内安装),装完重载插件才生效;不装完全不影响现有功能。诚实说明:本项目开发环境没装 Playwright,所以「渲染后的正文」没有实测数据;已验证的是壳页面能被正确识别、以及没装时静默回退——用excalidraw.com实测:HTML 6862 字节、可读仅 10 字符、含id="root",判定为壳页面,因未安装 Playwright 而回退。 -
受限网络下也能用。 梯子开着并且设为系统代理时,不用配置任何东西;关掉梯子会自动退回直连,不会因此报错。 技术补充:代理来源依次是配置里的
proxy、环境变量DSH_WEB_SEARCH_PROXY/HTTPS_PROXY/ALL_PROXY/HTTP_PROXY、操作系统系统代理(macOS 的scutil、Windows 的 Internet 设置);只支持 HTTP 代理(CONNECT),不支持socks5://。 -
所有设置都能在界面上改,不用编辑文件。 设置页有 30 个控件,分六组;保存后下一次搜索就生效;只有
cachePersist/cacheFile(决定缓存接线)和toolSurface(工具注册表在挂载时构建)要重载插件。 技术补充:30 个字段全部标了.volatile(),Host 以 live commit 方式原地更新,不重挂载插件;cacheTtlMs与cacheEntries每次使用都重读;抓取提供方在挂载时取走proxy、timeoutMs、fetchFormat、fetchMaxLength;renderJs与renderTimeoutMs每次抓取重读;缓存接线也在那时取走cachePersist与cacheFile。 -
失败会解释原因,不会静默返回空。 一家都没成功时,报错里会列出「试过哪些引擎、各自为什么失败」。 技术补充:失败按
SEARCH_THROTTLED/SEARCH_BLOCKED/SEARCH_TIMEOUT/SEARCH_NETWORK/SEARCH_PARSE/SEARCH_ABORTED分类;失败是返回值,不是异常,只有调用方取消才抛出。 -
被验证码挡住时,明确报错,而不是假装没结果。 360 从部分网络会返回验证码页,但 HTTP 状态仍是 200。旧版本把它当成「0 条结果」静默吞掉:引擎等于消失,冷却也没触发。现在这类页面会被识别成失败,360 也降为兜底档。 技术补充:
looksLikeBotWall在解析前检查qcaptcha、访问异常、unusual traffic、verify you are human、安全验证等标记;命中就返回SEARCH_BLOCKED(可重试、参与冷却),而不是空列表。so的tier从primary改为fallback,只在主引擎一条都没给时才尝试,不再拖慢每次搜索。实测单独查该引擎现在返回失败so: bot verification page,而不是 0 条。 -
包、仓库、论文、问答能直接查。 问「这个 npm 包还维护吗」「有没有讲 RAG 的论文」时,模型可以用
domain_search直接查 34 个专门的数据源,而不是拿网页搜索碰运气。 技术补充:34 个免密钥源,默认开 8 个——github、npm、pypi、arxiv、wikipedia、hn(Hacker News)、stackexchange、crates(crates.io);其余 26 个通过sources指定。参数query(必填)、sources(可选数组,缺省 = 默认 8 个)、limit(可选,默认 5、上限 20)、timeRange(可选off/day/week/month/year,只保留窗口内有日期的结果;没有一条有日期时才保留无日期结果,并给出note)。带时间窗时,arXiv 适配器会改用submittedDate排序并给查询加引号,再做本地日期过滤。每个源独立超时(默认 8000 毫秒),单源失败不影响其他源,失败名单从failures返回。实测react、limit 3 时 github/npm/arxiv/wikipedia/hn/stackexchange/crates 各 3 条、pypi 1 条。已知限制:PyPI 没有公开搜索 API,只按精确包名查(取查询的第一个词);Wikipedia 按提问语言只查单一语言(含中日韩字符查zh,否则查en)。宿主没有ctx.tools服务时,工具不注册,插件其余功能照常。 -
可以只看最近发布的结果。 设置里选「最近 24 小时 / 7 天 / 30 天 / 1 年」,就只留窗口内发布的结果,适合追新闻和版本更新。 技术补充:
timeRange五值off(默认)/day/week/month/year,分别是 24 小时、7 天、30 天、1 年;发布日期从各引擎结果里解析(Bing 的摘要日期与news_dt、360 的「发贴时间」、DuckDuckGo 的时间戳与摘要、AnySearch 正文末尾的date:)。DuckDuckGo 把窗口下推成df=d/w/m/y参数;Bing 与 360 的参数实测无效(页面显示已选中但结果不变),因此这两家与 AnySearch 走本地过滤。开启后只保留窗口内的带日期结果;只有当一条带日期的都没落进窗口时,才退回无日期结果,避免空手而归。这个设置是全局的;advanced_search可以在单次模型调用里临时覆盖(见下一条)。 -
一次问好几件事,只占一次调用。 「比较这三个库」这类问题,模型可以把 1–5 条查询交给
search_many,每条查询的结果分开返回;批内最多 3 条同时跑,某一条失败不影响其他条。 技术补充:queries(1–5 条,必填)、limit(默认 5,1–20)、withSites(默认 false,为 true 时每条结果附带域名)。SEARCH_MANY_CONCURRENCY = 3。每条查询走与web_search相同的引擎层、缓存和冷却记录;抛出的失败只记进该条查询的failures,不会中断整批。查询里明确写了 npm、PyPI 或 crates.io 时,会改走对应的包注册表;注册表没结果时再回退到普通搜索。一次多问用search_many,单问用web_search,查包/论文/问答用domain_search。工具超时 30 秒,声明为可并发。名字被占用时注册为web_search_many;宿主没有ctx.tools时不注册。 -
缓存能活过重启。 重启 DSH 后十分钟内再问同一个问题,上次的结果还在,不用重新打扰搜索引擎。 技术补充:
cachePersist(默认开启true)、cacheFile(默认空 =~/.dsh/cache/dsh-web-search/cache.json)。只保存摘要(url/title/snippet/publishedAt),不保存正文。默认上限 4 MiB,超出按最久未用淘汰,原子写(同目录临时文件 +rename);文件损坏、版本不符或读不了都当作空缓存,绝不会因此让插件启动失败。两个进程同时写同一文件是「后写覆盖」,但不会写坏文件。cacheTtlMs/cacheEntries改完立即生效,不需要重启。 -
搜索质量有了可重复的基准。 改排序不再靠感觉:仓库里有一组固定的 20 条查询,每次改完都能跑出同一套分数。 技术补充:
bench/下 20 条查询(中文 10、英文 10),四类各 5 条(文档 / 版本发布 / 包与库 / 新闻),每条标注 1–3 个期望域名。node scripts/bench.mjs离线读夹具重放,不联网,输出 precision@8、recall@8、MRR@8 与每个引擎的贡献;--record联网重新录制(每条限速 1.5 秒),用于更新夹具;--json输出机器可读结果,便于版本间对比,历史结果存在bench/results/。当前基线(0.24.x 重放,沿用 0.15.0 的 tier 回放协议):P@80.4375、R@80.7917、MRR@80.8071;中文0.4000 / 0.8167 / 0.7976,英文0.4750 / 0.7667 / 0.8167。另有五条中文长查询的独立诊断集(bench/queries-long.json,用--queries ... --fixtures ...录制):0.4500 / 1.0000 / 0.7667,五条都命中期望域名;它与 20 条基线分开保存,避免改变基线的可比性。对照实验和已知短板见附录。 -
一次调用完成小调研。 问「官方文档和另外两个来源到底怎么说」时,
research先跑最多三条查询,再用与web_fetch相同的抓取阶梯打开靠前的页面,最后返回一份证据包:每段摘录下面就是它的 URL。打不开的页面按 URL 和原因列出,不会让整份证据包失败;人机验证页和登录跳转页会被拒绝,不会被当作证据引用。 技术补充:参数query(必填)、queries(最多再加三条)、maxSources(1–5,默认 3);整次调用共享 45 秒预算,最多 3 个页面并发抓,剩余不足 2.5 秒就不再开新页。候选行先过相关性门槛;命中查询的政府、学术、标准组织和常见官方文档页面会排在前面,首页/落地页不会仅凭权威度被抬高,完全不相关的官方页面仍会被排除。未用完的查询名额(总共三条)可以补聚焦的官方site:查询(欧盟/europa、中国网信办、Chrome Releases、Python、Redis、W3C),结果再按发布机构域名过滤。抓取侧每页最多读 20 万字符,摘录选择器因此能找到正文深处的数字或原话;它使用独立的http-proxy-researchprovider,不会干扰宿主web_fetch的渲染缓存。W3C WCAG 页面 403 时会经w3c.github.io重试一次;正文取自这个官方镜像,引用仍给 W3C 原页面。搜索侧复用web_search的同一条链路、缓存与冷却。若research名字已被别的插件占用,则注册为web_research。
社区与视频平台
platform_search 是 domain_search 的社区/视频版:B 站、V2EX、Reddit、
YouTube、知乎和掘金能用免密钥公开接口的先用接口,被挡或接口变了就用
site:<域名> 走普通搜索兜底。单个平台失败不会拖垮整批;返回里给出平台、
URL、摘要和能拿到的日期。兜底结果还会按平台域名过滤,防止普通网页冒充平台
结果。B 站的 /search/type 返回 412 时会再试 /search/all/v2;只有查询明确要“最近/高播放”时才做时间过滤和播放量排序;掘金有互动数据时会显示点赞/阅读数。
技术补充:参数 query(必填)、platforms(可选,六选一或数组)、limit
(1–10,默认 5)。直接请求使用浏览器 UA 和配置的代理,失败后走
site:<域名> <query>;每个平台 8 秒直连超时,工具总预算 40 秒,结果去重后
按名次交错。名字被占用时注册为 web_platform_search。知乎没有可用的免密钥
搜索接口,只能走兜底;兜底也被挡时会明确报平台失败,而不是静默省略。
research 正文的二次检索
research 会抓完整页面,但证据包里只放挑选过的段落;cache_search 在进程内
对这些全文再做一次检索,不再发网络请求。第一次回答需要精确数字、原话或某一
节时,可以再问 cache_search,它返回命中的段落和同一批来源 URL。缓存最多
24 篇、每篇 40 万字符,7 天过期,插件卸载即清空,不把网页正文写进磁盘。
第一次挑选也不是简单截前 6,000 字:research 把正文切成窗口,按查询词打分, 保留最相关的窗口,再补上开头上下文,保证摘录读得懂。这个过程是确定性的, 不调用模型。
技术补充:cache_search 参数 query 和可选 limit(1–10,默认 3),返回
matches(url、title、snippet、score、fetchedAt)。缓存只在内存;
重启即空。research 为此每页最多读取 20 万字符,并通过可选的 onPage 回调
把全文交给缓存。
-
引擎能不能用,可以直接测。 模型工具和设置页按钮都能拿一条短查询逐个问引擎,回报谁答了、多快、其余的为什么没答。它只做诊断:不写缓存、不触发冷却、不回退。 技术补充:
engine_test可选参数engine和query,测单个或全部八个(并发 3),返回每个引擎的ok、latencyMs、count、failureKind、code、status、reason。设置页按钮走只监听本机的POST /api/dsh-web-search/engine-test桥,复用同一个 runner;非 POST、非回环地址和跨站来源都会被拒绝。宿主没有可注入的webServer时不注册,页面自然没有这个按钮。 -
失败带类别,回退是策略。 以前「被墙」「额度用完」「暂时超时」都会触发同样的回退;现在每次主引擎失败都会分类,你可以决定哪几类才允许切备用引擎。回退被跳过或真的用了,结果里都会说明。 技术补充:
FailureKind为quota/auth/bot-wall/transient/invalid-response/unknown,由原有的SearchErrorcode 加 HTTP 状态和消息线索判定。fallbackOn默认六类全开,保持旧的「总是回退」行为;留空表示从不回退。SearchOutcome.failureDetails暴露类别、code 和状态,note解释回退被跳过还是被使用(search_many也会渲染)。冷却时长不变。 -
可以屏蔽网站,也可以转发安全搜索。 把域名加进黑名单,它就会从融合结果和缓存结果里消失;选一个安全搜索级别,Bing 和 DuckDuckGo 会收到。 技术补充:
blockedDomains是逗号分隔的后缀名单(子域名匹配父域名),在融合之后和缓存命中时过滤,默认为空。safeSearch为off(保持引擎默认)/moderate/strict,以 Bingadlt、DuckDuckGokp转发,其它引擎不受影响。非空黑名单和非默认安全搜索都会进入缓存键,所以移除屏蔽不会复用已过滤的缓存;默认路径继续复用旧缓存。 -
时间窗可以按次指定,不必先改全局设置。 只有一条问题需要「最近一周」时,模型可以调用
advanced_search,给这一次调用传day/week/month/year,不用动设置。省略窗口就沿用全局timeRange;传off表示这一次不筛。 技术补充:参数是query(必填)、maxResults(默认 5,上限 20,且仍受部署limit限制)、timeRange(off/day/week/month/year;省略 = 设置值)。它和web_search共用引擎、缓存、冷却与失败路径:off可以复用普通缓存,week会落到自己的缓存键。显式传窗口时,它会从发给引擎的查询里去掉多余的「过去 7 天内」/last 7 days短语(结构化窗口已经表达了时间),但结果里的query仍是原句。当查询带窗口且明确问 Chrome 安全/发布时,它会读取 Chrome Releases 官方 feed,返回 feed 里的真实发布日期,并在note里说明标题或摘要是否出现 zero-day;查询明确要 Stable 时,会过滤掉 Beta/Dev/Early Stable/Extended Stable,并在每条摘要前给出帖子写明的版本、修复数和高/中/低危数量。feed 不可用或 Stable 过滤后为空时回退普通引擎。名字被占用时注册为web_search_advanced;宿主没有ctx.tools时不注册。 -
网页正文被显式标成不可信数据。 插件自有的每个工具现在都把网页来源正文包进
<untrusted-web-content>...</untrusted-web-content>,并先剥掉正文里伪造的同名标记;系统提示里再用一小段说明这些内容只是数据,不是指令。 技术补充:包装覆盖domain_search、search_many、advanced_search、read_page、research、engine_test的 render。包装前会删除正文里的边界标记(包括空白/属性变体),防止网页提前闭合边界。宿主自带的web_search/web_fetch外部内容提示保持原样,插件不重复、也不修改 DSH 结果卡片同样会显示的Source对象。提示段通过可选的systemPrompt注入安装;没有该服务的宿主自动跳过。
0.13.0 修了什么(一个真实缺陷):360(
so)从部分网络访问会返回验证码页(302 到 qcaptcha 的「访问异常页面」),但 HTTP 状态是 200。旧代码把它当作「0 条结果」静默吞掉:引擎等于消失,冷却也没触发。现在识别到验证码/人机校验页面就报SEARCH_BLOCKED失败,并把 360 降为兜底档(主引擎都空时才尝试),不再拖慢每次搜索。实测:单独查该引擎现在返回失败so: bot verification page,而不是 0 条。
工具面:一个入口,八个动作
0.20.x 改变了模型看到的工具面。上面的八种能力现在是同一个 web_tools
工具的不同 action,不再是八个独立注册。调用长这样:
{ "action": "domain_search", "query": "react", "sources": ["github"] }
宿主自带的 web_search 和 web_fetch 保持不变:常用路径不变,但可选的
工具名从八个压到一个。
旧提示词如果直接调用 domain_search、search_many、research 等名字,可以
在配置里显式回到旧工具面:
- id: web-search-bing
  name: '@fffangchenghao/dsh-web-search'
  config:
    toolSurface: legacy
默认 unified,推荐使用;切换模式需要重载插件,因为注册表在挂载时构建。
下面文档仍会用这些名字指代能力,默认请读作 web_tools 的 action。
自动更新
插件是 DSH bundle,不会替换自己正在运行的代码:Node 已经加载
lib/index.js,在进程下面换文件不是安全的更新方式。自动更新属于 profile
级更新器,而不是插件自己。
请使用 npm 安装,不要用 link:/本地 checkout:
dsh plugin --profile web add @fffangchenghao/dsh-web-search@latest
然后保持 dsh-autoupdater(或 dsh-self-upgrade)这类 profile
更新器开启。它会按计划检查 npm dist-tag,在空闲窗口更新,
桌面版提示重启。link:/file: 安装会被这类更新器主动跳过,因为用 registry
包替换本地 checkout 会破坏开发目录。
设置页会显示 npm 最新版。如果它比当前版本新,且页面在本地,还会显示
安装更新按钮。这个按钮不是自己跑 pnpm,而是调用 DSH 内置的
pluginManager(和 dsh plugin 同一条路径)安装精确的 npm 包,然后提示重启。
它不依赖 dsh-autoupdater;它只是手动的,不会定时轮询。远程 Web 页面
不显示按钮;link:/file: 安装会在替换前被拒绝。如果部署没有插件管理器,
按钮会明确报错,而不是假装更新成功。
自动更新是用「少一次人工 review」换「更快拿到修复」:更新器会直接安装 registry
包,不会等人读 diff。如果你的部署不能接受这个交换,就固定精确版本并关掉
profile 更新器。插件本身从不 fork/exec pnpm;手动按钮只是请 Host 执行安装。
安装与启用
你需要什么
- 一个带
web服务的 DeepSeek Harness profile(0.2.1-rc.2 实测;兼容范围声明为>=0.2.1-rc.2 <0.3.0,证据见 docs/store-evidence.md); - Node 22.18 以上(
engines声明为>=22.18.0;源码用了 Node 原生的 TypeScript 类型擦除,CI 跑 Node 24); - 能正常出网。没有梯子也能用,只是可用的引擎少一两个。
- 可选:想读靠 JavaScript 渲染的页面,自己装 Playwright(见能力清单第 12 条);不装不影响任何现有功能。
生产安装(可自动更新)
普通用户直接把已发布包加进 profile;想让 profile 更新器管理,就不要用
link::
dsh plugin --profile web add @fffangchenghao/dsh-web-search@latest
Windows
插件没有原生扩展,Node 22.18 以上即可。PowerShell 里的安装命令完全一样:
dsh plugin --profile web add @fffangchenghao/dsh-web-search@latest
如果 dsh 不在 PATH,用 DSH 安装目录里的 CLI 执行同一条命令,或者在
Settings 的插件管理器里安装这个 npm 包。安装后重启一次 DSH。
插件会读取 Windows「Internet 设置」里的系统代理(Clash 等客户端写入的
ProxyEnable / ProxyServer),也会回退到 HTTPS_PROXY / HTTP_PROXY /
DSH_WEB_SEARCH_PROXY。只提供 PAC 的代理不会被执行,请显式填写 proxy
设置。缓存位置是 %USERPROFILE%\.dsh\cache\dsh-web-search\cache.json。
下面是从源码 checkout 开发的路径。
第一步:构建
仓库里的 main 指向 lib/index.js,而 lib/ 已经随仓库提交(DSH STORE 只扫描固定 Commit 的 Git 树,运行产物必须入库),所以拿到代码就能直接跑;只有改了 src/ 才需要重新构建:
cd ~/.dsh/plugins/dsh-web-search-bing
npm run build
第二步:确认 bundle 的 patch
插件包自带 cordis.patch.yml,内容是一行插入:
- insert:
    - id: web-search-bing
      name: '@fffangchenghao/dsh-web-search'
如果你是通过 pnpm install / link: 装进 profile 的,这一行会自动生效,不用手抄。仓库里这份 patch 还带了一个空的 config: {},作用是让设置页能发现这一行、显示卡片而不是「当前部署尚未提供此插件的设置」。
还没装进 profile 的话,在该 profile 的 package.json 里加一条依赖,再安装:
"dependencies": {
  "@fffangchenghao/dsh-web-search": "link:/Users/dp/.dsh/plugins/dsh-web-search-bing"
}
cd ~/.dsh/profiles/desktop
pnpm install
路径换成你本机的仓库位置;本机的 profile 用 pnpm 管理依赖,换用别的包管理器时照你自己的习惯来。
第三步:在 profile 里选中提供方
打开你正在用的 profile 的 cordis.patch.yml。本机是:
~/.dsh/profiles/desktop/cordis.patch.yml
别的机器上把 desktop 换成你实际用的 profile 名(web、headless 等)。加上这一段:
- id: web
  name: "@deepseek-ai/dsh-web"
  config:
    searchProvider: bing
    fetchProvider: http-proxy
bing 和 http-proxy 都是本插件注册的 id。如果你只想换搜索、不想让抓网页也走插件,把 fetchProvider 写成 http(Harness 自带的直连实现)。
再往下可以加一段可选配置,比如:
- id: web-search-bing
  name: '@fffangchenghao/dsh-web-search'
  config:
    limit: 8
    wait: auto
    proxy: ""            # 留空自动探测
    anysearchApiKey: ""  # 留空表示匿名访问
    anysearchDomain: ""  # 或 finance / academic / security / legal / code
    firecrawlApiKey: ""  # 可选;免 key 兜底配额很紧
    timeRange: off       # off / day / week / month / year
    renderJs: auto       # auto / always / off
    renderTimeoutMs: 15000
    domainLimit: 5       # domain_search 每个源返回几条
    domainTimeoutMs: 8000
密钥放哪:放在 profile 的 cordis.patch.yml 里,不要放进仓库。仓库里 bundle 的默认配置是空的,这样发布出去不会带上你的凭据。
第四步:完全重启
改完代码或 profile 配置后,完全退出 DSH 再打开(macOS 按 Cmd+Q;Windows 从托盘或菜单退出,不能只关窗口)。原因是模块在每个进程里只求值一次,热改文件不会被已运行的进程看见。
设置页里大部分值不需要重启,例外情况见下一节。
第五步:确认生效
三个办法,任选:
- 看设置页:设置 → 「网页搜索(Bing)」,能看到六组、共 30 个控件,说明插件被加载了,schema 也被 Host 收录了。
- 看日志:启动日志里没有
1 entry did not activate这类警告。 - 直接试:问一个明显需要联网的问题,比如「帮我搜一下 DSH 插件开发教程,给我链接」。看模型有没有调用
web_search,返回的链接是不是真实可达。
如果设置页有卡片但搜索还是失败,先看排障文档:docs/troubleshooting.md。
设置页怎么用
打开 设置 → 「网页搜索(Bing)」。页面上一共 30 个控件,按六组排列,外加一个引擎健康检查。顶部有一条随滚动固定的跳转栏,点组名直接跳过去;标题下还会拿当前版本和 npm 上的最新版比一下(连不上 npm 时这行不显示,不会瞎猜)。每组只管一类事:
| 组 | 控件数 | 这组管什么 |
|---|---|---|
| 引擎与传输 | 9 | 用哪些搜索引擎、等多久、走不走代理、AnySearch 的凭据和垂直域 |
| 结果与排序 | 7 | 返回几条、只看多久内、怎么合并排序、官方文档和新内容加权多少 |
| 专用检索 | 3 | domain_search 查哪些源、每个源返回几条、每个源等多久 |
| 抓取 | 4 | web_fetch 返回 Markdown 还是纯文本、最多返回多少字符、要不要用浏览器渲染空壳页面、渲染最多等多久 |
| 缓存与冷却 | 6 | 结果记多久、记多少条、要不要写进硬盘、被限流后歇多久 |
| 模型工具 | 1 | 八种可选能力是统一成一个 web_tools,还是保留旧的八个工具名;切换后要重载 |
引擎与传输(9 个)
| 控件 | 配置键 | 默认 | 人话 |
|---|---|---|---|
| 只查哪些引擎 | hosts | 空(全部) | 只让列出的引擎参与,逗号分隔,如 anysearch, cn.bing |
| 等多久 | wait | auto | auto 按提问语言等;all 等全部;fast 谁先回用谁 |
| 等待上限(毫秒) | timeoutMs | 15000 | 单个引擎最多等多久,最小 500 |
| 代理(中转站) | proxy | 空(自动探测) | 如 http://127.0.0.1:7890;留空先读环境变量再读系统代理 |
| AnySearch 通行证 | anysearchApiKey | 空(匿名) | 可选项。只发给 api.anysearch.com,用于提高额度、解锁正文抽取。可以用逗号分隔填多个 key,插件轮流使用;某个被限流或拒绝会自动休息 |
| 专业领域 | anysearchDomain | 空(通用) | 常见取值 finance / academic / security / legal / code,可带子域如 finance.us_stock |
| Firecrawl 通行证 | firecrawlApiKey | 空(匿名) | 可选项,只影响兜底梯队;匿名端点共享配额很紧,连续扫描可能返回 429 |
| 屏蔽网站 | blockedDomains | 空(不屏蔽) | 永远不要出现在结果里的网站,逗号分隔;子域名会一起屏蔽。在融合之后和缓存命中时都会过滤,所以被屏蔽的行不会从缓存里回来 |
| 安全搜索 | safeSearch | off | off 保持引擎默认;moderate / strict 会以 Bing adlt、DuckDuckGo kp 转发,其它引擎忽略 |
| 哪些失败可回退 | fallbackOn | 六类全开 | 允许切备用引擎的失败类别:quota、auth、bot-wall、transient、invalid-response、unknown。留空表示任何失败都不回退;被跳过的回退会写进结果的 note |
结果与排序(7 个)
| 控件 | 配置键 | 默认 | 人话 |
|---|---|---|---|
| 返回几条 | limit | 8 | 最多返回几条,1–20;调用方要得更少时以调用方为准 |
| 只看多久内 | timeRange | off | off 不限;day 最近 24 小时、week 7 天、month 30 天、year 1 年。开了只留窗口内的结果。advanced_search 可以给单条查询临时覆盖 |
| 结果混合力度 | rrfConstant | 60 | 越大越平均,越小越偏向各引擎的头部结果 |
| 可信网站名单 | authorityDomains | 空(用内置列表) | 在内置的官方文档域名之外,追加你想加权的域名 |
| 可信网站加分 | authorityBoost | 0.25 | 命中可信域名时乘 1 + 这个值,0–10 |
| 新内容加分 | freshnessBoost | 0.2 | 新发布内容的加成,0–10;随时间线性衰减到 0 |
| 多少天内算新 | freshnessDays | 30 | 超过这个天数就不再加成 |
专用检索(3 个)
| 控件 | 配置键 | 默认 | 人话 |
|---|---|---|---|
| 查哪些专用源 | domainSources | 默认八个 | 在 34 个源里只留几个(如 github,npm),逗号分隔;留空表示默认八个。sources 参数可以点名任意一个源 |
| 每个源返回几条 | domainLimit | 5 | domain_search 每个源最多返回几条,1–20 |
| 每个源等多久 | domainTimeoutMs | 8000 | 单个专用源最多等多久(毫秒),最小 500;网慢可调到 15000 |
抓取(4 个)
| 控件 | 配置键 | 默认 | 人话 |
|---|---|---|---|
| 返回格式 | fetchFormat | markdown | markdown 保留标题、列表、表格、链接和代码;text 只留文字。阅读场景保持 markdown,想更小更朴素再选 text。改完立即生效 |
| 最多返回多少字符 | fetchMaxLength | 20000 | 一次抓取最多返回多少转换后的字符,1000–200000;超出会在末尾注明原始长度。长文档可调到 50000。改完立即生效 |
| JS 渲染 | renderJs | auto | auto 只在页面像空壳时用浏览器;always 每次都渲染;off 从不渲染。需要自己另装 Playwright,没装就静默跳过、返回原页面。改完立即生效 |
| 渲染等待上限(毫秒) | renderTimeoutMs | 15000 | 一次浏览器渲染最多等多久,1000–120000;页面很重可调到 30000。改完立即生效 |
缓存与冷却(6 个)
| 控件 | 配置键 | 默认 | 人话 |
|---|---|---|---|
| 缓存保留多久 | cacheTtlMs | 600000 | 10 分钟;填 0 关闭缓存。改完下一次搜索就按新值走 |
| 缓存条数上限 | cacheEntries | 100 | 最多记多少个问题,超出淘汰最久没用的。改完下一次搜索就按新值走 |
| 是否写入硬盘 | cachePersist | true | 把缓存存成文件,重启后还能命中;不想留痕或磁盘只读时关掉。改完立即生效 |
| 缓存文件 | cacheFile | 空(默认路径) | 快照写到哪;留空用 ~/.dsh/cache/dsh-web-search/cache.json。插件挂载时读取 |
| 被拒后歇多久 | baseCooldownMs | 300000 | 被限流后第一次歇多久,5 分钟 |
| 歇息上限 | maxCooldownMs | 1800000 | 连续失败时冷却翻倍的上限,30 分钟 |
模型工具(1 个)
| 控件 | 配置键 | 默认 | 人话 |
|---|---|---|---|
| 工具面 | toolSurface | unified | unified 只注册一个 web_tools,用八个 action;legacy 保留旧的八个独立工具名,兼容旧提示词。切换会重建注册表,保存后要重载插件 |
给你的建议
只想正常用:30 个控件全都别改,默认值就是调过的。
只有这些情况值得动:
- 代理没被自动探测到:在
proxy里填上你的本地代理地址,比如http://127.0.0.1:7890。只支持 HTTP 代理,socks5://要换成客户端的 HTTP/mixed 端口。 - 你想要 AnySearch 的更高额度或正文抽取:填
anysearchApiKey;想只搜某个垂直领域再填anysearchDomain。 - 你只想让
domain_search查某几个源:把domainSources收窄成github,npm这类组合;留空就是默认八个;其余 26 个(如dockerhub,openalex)通过sources按需开启。 - 抓回来的正文断得太早,或只想要纯文字:把
fetchMaxLength调到50000,或把fetchFormat改成text;如果调大也不够、要接着读下半段,用read_page(见能力清单第 11 条)。 - 抓回来是个空壳页面:先确认正文是不是靠 JavaScript 生成。自己装了 Playwright 就把
renderJs留在auto,重载插件后再试;没装就换一个来源(打印版、静态镜像、站点 API)。调大fetchMaxLength只对「抓到了但被截断」有用,变不出正文。 - 浏览器渲染太慢:把
renderJs改成off,或把renderTimeoutMs调小。 - 不想在硬盘上留缓存文件:关掉
cachePersist,或把cacheFile指到别处。
三个提醒:
- 保存是即时的,下一次搜索就按新值走,不用重启——只有
cachePersist和cacheFile例外,它们决定缓存怎么接线,在插件挂载时读取。 - 但排序类的改动可能被缓存挡住:缓存键里有
lead|wait|limit|引擎集合|时间窗|query这些字段,但没有排序参数。同一个问题十分钟内再问,拿到的还是旧顺序——开了持久化后,重启 DSH 也清不掉。换个问法,或者等十分钟。改时间窗会换一个键,所以不受旧缓存影响。 web_fetch不能从中间续读:它对一个网址只发一次请求,尾巴缺了可以调大fetchMaxLength,也可以用read_page从断点接着读;抓一个更窄的页面仍然最省上下文。
常见问题 FAQ
需要 API key 吗?
不需要。搜索默认全部走公开渠道:AnySearch 匿名访问、Bing 和 360 抓结果页、DuckDuckGo 抓 HTML 页。anysearchApiKey 是可选的,填了额度更高,也能在 web_fetch 直连和隧道都失败时启用最后一级「服务端抽取」。
会不会花我的钱?
插件本身是 MIT 开源、免费的,不调用任何付费搜索 API,也不含购买入口。有两件事和钱有关,但都不是插件收的:
- 你自己填的 AnySearch key,用量和计费按 AnySearch 的规则算在你账号上;
- 搜索产生的网络流量算你自己的。
会不会把我的搜索内容发给别人?
会发给本次参与的搜索引擎——这是搜索本身的意思。具体是 api.anysearch.com、cn.bing.com、www.so.com,有代理时还包括 DuckDuckGo 和 Bing 国际站;配了 key 时,抓取失败的页面可能被发给 api.anysearch.com 的抽取接口。插件没有自己的服务器,代码里也没有上报使用情况的逻辑。自己装了 Playwright 时,页面是在本机浏览器里打开的,网址不会交给插件之外的第三方。
为什么某个网站抓不到?
常见原因有四类:
- 站点拒绝自动访问:回 403 或验证页。自己装了 Playwright 且页面还有内容时,
renderJs: auto会先试本机浏览器;否则直连、隧道都过不去时,只有配了 AnySearch key 才会尝试服务端抽取。 - 正文靠 JavaScript 渲染:抓回来的是空壳 HTML,看不到内容。装了 Playwright 后会自动渲染;没装就只能看到壳。如果去壳之后一个字都不剩,插件会报错(
SEARCH_EMPTY)并写明「没有可用渲染器」之类的判定,而不是把空壳当成成功结果返回。 - 要登录或付费:抓取没有你的登录态。
- 直连超时:会先在 5 秒内试直连,失败转隧道;两个都不通、又没配 key 时报错,配了 key 还会再试服务端抽取。整条梯队总共只有 25 秒预算,后面的档位只能花剩下的时间。报错里会写清楚每一级失败的原因。
- 二进制文档:PDF、图片、压缩包会明确拒绝(
SEARCH_UNSUPPORTED)并告出内容类型,不会把字节流当成正文塞给你。例外是 arXiv 的/pdf/<id>链接:抓取阶梯会把它改写成 arXiv 的 HTML 全文,因此无需另装 PDF 提取器就能读论文。其他 PDF 仍建议先用别的工具取文本。
360 的验证码页属于第 1 类,但它以前特别隐蔽:从部分网络访问会 302 到 qcaptcha 的「访问异常页面」,HTTP 状态却是 200。插件现在会把它记成 SEARCH_BLOCKED,单独查该引擎会看到 so: bot verification page,而不是 0 条;360 也因此降为兜底档。
为什么抓回来的内容和浏览器看到的不一样?
因为 web_fetch 不是浏览器:
- 它只留正文,不留页面装修:转换前会剔掉导航、广告、脚本、页脚、表单和隐藏节点;标题、段落、列表、代码、引用、链接、图片和表格保留。
- 它默认不执行 JavaScript:正文靠前端渲染的页面抓回来接近空壳。自己装了 Playwright 并开启渲染后,这一条不再成立——浏览器会把正文补全;开关、超时和「什么算壳页面」见能力清单第 12 条。
- 它会截掉尾巴:超过
fetchMaxLength(默认 20000 字符)的转换后正文,会被一行提示替代,提示里写明原始长度,所以长页面会提前结束。要接着读下半段,用read_page(见下一问)。
如果正文断得太早,先用 read_page 接着读(见下一问);也可以把 fetchMaxLength 调大(50000 是个合适的值)。如果拿回来就是个空壳,先按下面「页面抓回来是空的怎么办?」处理;装不了浏览器就试它的打印版、静态镜像,或者站点自己的 API。
网页太长一次读不完怎么办?
用 read_page。先照常抓一次(offset 省略或写 0),结果里会带 nextOffset;把它原样传给下一次调用的 offset,直到 nextOffset 为 null。
- 只需要某一段:直接给
offset,比如从第 40000 个字符开始; - 想要更大段:把
maxLength调大(默认取设置里的fetchMaxLength,最多 200000); - 想换纯文本:
format: "text"(默认取设置里的fetchFormat)。
totalLength 是整页正文长度,chunk.index / chunk.count 告诉你读到第几段。同一页会缓存,续读不会反复下载;truncated: true 只表示来源本身被截断(超过 2,000,000 字符的安全上限,或传输层截断),不代表还有下一段——还有没有,看 nextOffset。
如果页面本来就不长,web_fetch 一次能读完,不需要 read_page。read_page 和 web_fetch 一样走四级抓取梯队,所以代理、渲染和 AnySearch 抽取的配置照样生效。
页面抓回来是空的怎么办?
先判断它是不是「壳页面」——HTML 里只有标题和加载脚本,正文要等 JavaScript 跑完才出现。然后按顺序试:
- 自己装了 Playwright(
npm i -g playwright && npx playwright install chromium):把renderJs留在auto,重载插件后再抓。插件会识别壳页面,开一个无头 Chromium 把正文渲染出来;always可以强制每次都渲染,off则完全禁用。 - 没装 Playwright:插件不会自动装;如果抓回来完全没有可读正文,它会明确报错(
SEARCH_EMPTY),信息里说明是否因为没有渲染器,而不是返回一个空壳当成功。这时换一个来源(打印版、静态镜像、站点 API),或者把fetchMaxLength调大——但后者只对「其实抓到了、只是被截断」的情况有用,变不出正文。 - 页面本身要登录或付费:渲染也救不回来,抓取没有你的登录态。
插件会不会偷偷装浏览器?
不会。package.json 里没有 Playwright,插件也不会在运行时下载或安装任何东西。只有你自己已经装过 playwright 或 playwright-core,渲染才会启用;没装就静默跳过,抓取照常返回未渲染的页面,原因写在结果里。装完要重载插件,因为加载器会缓存「没装」这个结论。
你们怎么知道搜索质量变好了?
靠 bench/ 里的固定查询集,而不是拍脑袋。20 条查询(中文 10、英文 10),文档 / 版本发布 / 包与库 / 新闻四类各 5 条,每条标注 1–3 个期望域名。node scripts/bench.mjs 离线重放录好的夹具,输出 P@8 / R@8 / MRR@8。当前基线(沿用 0.15.0 的 tier 回放协议)是 0.4375 / 0.7917 / 0.8071;中文 0.4000 / 0.8167 / 0.7976,英文 0.4750 / 0.7667 / 0.8167。改排序前后各跑一次,数字是变好还是变坏一目了然。样本只有 20 条,不能当统计显著性;新闻类 recall 只有 0.467,逐条输出会把每次没命中都打出来——这些短板都写在附录里。
为什么搜索结果和我手动搜的不一样?
因为这不是同一件事:
- 它抓的是多个引擎的结果页,不是某个引擎的官方接口,各家的排序本来就不一样;
- 它按 URL 去重,再按跨引擎投票、官方文档、新鲜度重新排序;
- 它优先用和提问语言同侧的来源,中文问题会先看中文站点;
- 它可能用到十分钟前的缓存,也可能某家正在冷却没参与;
- 它没有你的账号、位置、浏览历史,不会个性化。
为什么开了时间过滤结果变少了?
因为时间过滤会拿掉「日期不在窗口内」的结果。开启后它只保留窗口内带日期的结果;没有日期的结果不算数,因为无法证明它够新——这是刻意的取舍:宁可少给几条,也不拿一篇不知道哪年的页面冒充「最近 24 小时」。
唯一的例外是兜底:如果一条带日期的结果都没落进窗口,它会退回无日期的结果,免得你空手而归。所以看到的结果条数可能是 0 到 8 条之间,而不是固定的 8 条。
缓存会不会把旧答案一直给我?
不会。每条缓存在写入 cacheTtlMs 之后过期——默认 10 分钟——所以窗口内重复问拿到的是旧答案,下一次就会重新去问引擎。三件事把它关在笼子里:
cacheTtlMs: 0直接关掉缓存;cacheEntries(默认 100)限制最多存几条,超出淘汰最久未用的;- 硬盘快照只存摘要(
url、title、snippet、publishedAt),不存正文; - 过期时间是绝对时间:从硬盘重新载入的条目沿用原截止时间,载入时就把过期条目丢掉,所以重启 DSH 不会给缓存「续命」。
domain_search 和 web_search 该用哪个?
看你要找的是网页还是条目:
- 查概念、新闻、官网、教程、报错信息 → 用
web_search,它查的是公开网页; - 查包、代码仓库、论文、问答、百科条目 → 用
domain_search,它直接问 GitHub、npm、PyPI、arXiv、Wikipedia、Hacker News、Stack Exchange、crates.io。
两者可以接力:domain_search 找到包或论文的条目,再用 web_fetch 打开主页或 README 读细节。
一次问多个问题怎么最快?
用 search_many。一次调用带 1–5 条 queries,批内 3 条并发,每条查询的结果分开返回;limit(默认 5)限制每条查询返回几条,withSites: true 会附上每条结果的域名。某条查询失败只变成它自己的 failures 一行,不会中断整批。单个问题用 web_search;目标是包、仓库、论文或问答时用 domain_search。
改了设置为什么没生效?
分三种情况:
- 在设置页改的:保存即生效,下一次搜索就读新值;
fetchFormat、fetchMaxLength每次请求重新解析,renderJs、renderTimeoutMs每次抓取重新解析,所以都不用重启——只有cachePersist和cacheFile在挂载时决定缓存接线。如果问的是同一个问题、十分钟内又问了一遍,可能命中了缓存,看起来像没变——换个问法试试;开了持久化后,重启也不会清掉缓存。 - 改的是 profile 里的
cordis.patch.yml:需要完全重启 Harness。 - 改的是
src/*.ts:需要npm run build再重启。只改源码不构建,跑的还是lib/里的旧代码。
会不会拖慢模型?
会多一点等待,但通常值得:
- 一次搜索实测 1.4–3.8 秒(英文多等一会儿,中文快一些);命中缓存时几乎瞬间。
- 这段时间模型在等工具结果,不是卡死;等不到会按软截止返回已经拿到的部分。
- 真正的成本在上下文:搜索结果和网页正文都会占用模型的输入长度,读的页面越长,这一轮越贵、越容易挤掉别的内容。所以它默认只返回 8 条,抓回来的正文先转换、再按 20000 字符截断(原始响应体另外限制在 1 MiB)。
为什么模型有时候还是不搜?
搜不搜是模型自己决定的,插件只负责「被调用时把活干好」。它可能觉得自己知道答案,可能觉得问题不需要联网,也可能上一轮已经拿到了足够信息。你可以直接说「先搜一下再回答」,通常就会触发。
技术说明(附录)
这一节给要改代码或排查问题的人。日常使用可以跳过。
一次搜索的管道
web_search 调用
  → 读配置(每次调用重读,所以设置页改动立即生效)
  → 解析代理(配置 → 环境变量 → 系统代理)
  → 按 hosts 白名单过滤;没有代理时丢掉 viaProxy 引擎
  → 跳过正在冷却的引擎(但绝不会一个都不剩)
  → 按查询语言决定主导区(ASCII → global,CJK → cn)
  → 查缓存(先内存、再硬盘快照;键:lead|wait|limit|排序后的引擎 id|时间窗|归一化 query)
  → primary 档并发请求,达到释放条件即返回
  → 一条结果都没有时,跑 fallback 档
  → 各引擎按 timeRange 本地过滤(DuckDuckGo 另有 df 下推)
  → 按区域融合 + RRF 排序,截到 limit
  → 合并后再按时间窗收一次(一条带日期的都没落进窗口时退回无日期结果)
  → 写入缓存并标记快照待刷新,返回 { sources, failures, proxy }
一档的释放条件是四者之一:所有引擎都落定;主导区所有引擎都落定(无论成败);已凑够 limit 条且贡献者数达标;软截止到点。到点还在跑的引擎会被中止,并在失败列表里记为 still running at deadline 或 aborted once enough results had arrived。
单引擎失败会被分类,构造成 SearchError 返回,而不是抛出去——一家挂了不该拖垮整次搜索。
排序公式
score(source) = votes / (rrfConstant + position)
                × (命中权威域名 ? 1 + authorityBoost : 1)
                × 新鲜度系数
position:各引擎列表按加权轮转交错后,这条结果的 1 起始位置。权重 2 的引擎每轮占两个连续槽位(AnySearch 是 2,其余是 1)。votes:返回过这条结果的不同引擎数。两家都说好,分数翻倍;一家权重再高也不会。- 权重只影响「入选名额」,不乘到分数上。这一点是实测修正的:早期版本把权重当分数乘子,
rrfConstant = 60时权重 2 会在每个名次上压过其他引擎,CJK 查询直接变成 AnySearch 独占 8 条、中文引擎一条不剩。现在权重 2/1/1、三个列表 10/10/4 条、limit: 8时,名额是 4/2/2。 - 新鲜度系数:
1 + freshnessBoost × (1 − ageDays / freshnessDays),超过窗口就是 1;日期解析失败也按 1 处理,不惩罚。 - 平局依次比较:引擎顺序 → 该引擎内的排名 → URL 字符串,所以同样的输入永远得到同样的顺序。
新鲜度现在算的是真实日期:publishedAt 从各引擎的结果里解析出来,freshnessBoost / freshnessDays 不再空转。解析失败、或者结果本来就没日期的,按 1 处理——不惩罚也不加分。时间窗过滤发生在引擎层和合并之后,排序本身只负责打分。
发布时间与时间窗
各引擎把日期写在不同的地方,解析器把它们统一成 ISO 8601 UTC:
| 引擎 | 日期从哪来 |
|---|---|
| Bing | 摘要开头的日期(2025年9月25日、2 天之前),或 news_dt 时间戳元素 |
| 360 | 单独的「发贴时间:2026年1月22日」 |
| DuckDuckGo | result-timestamp / result__timestamp 元素,或摘要里的日期 |
| AnySearch | 正文末尾追加的 date: 22 hours ago |
细节:
- 绝对日期一律用
Date.UTC且锚定当天 UTC 正午,所以同一个日期在上海、柏林、洛杉矶都是同一时刻,不会因为机器时区漂到前一天。 - 相对日期(
3 天前、22 hours ago、昨天)按滚动时间算,不按日历天减,避开时区和夏令时问题。 timeRange的五档对应 24 小时、7 天、30 天、365 天:day/week/month/year,off表示不过滤。- 下推与本地过滤:DuckDuckGo 的
df=d/w/m/y是真参数,实测会改变结果集;Bing 和 360 的时间参数实测无效——页面把选项显示成已选中,返回的结果却不变——所以它们和 AnySearch 一样,在本地按解析出的日期过滤。 - 无日期结果的处理:开启窗口后只保留窗口内带日期的结果;只有当一条带日期的都没落进窗口时,才退回无日期结果,避免空手而归。解析失败与没有日期同等对待,因为「解析不出来」不等于「很旧」。
- 未来日期不算越界:它仍在窗口内,排序时把年龄夹到 0。
- 缓存键在窗口非
off时会多带一段timeRange,所以切换窗口不会命中旧窗口的缓存;off的键与旧版完全一致。 - 实测:查询
latest AI news,off下返回 8 条(其中 5 条带日期);day下返回 5 条,且全部带日期。
缓存与冷却
缓存是 TTL + LRU:条目在 cacheTtlMs(默认 600000,即 10 分钟)后过期,超过 cacheEntries(默认 100)条时淘汰最久未使用的一条;cacheTtlMs: 0 直接关闭。存取都会拷贝数组和每个对象,调用方改不动缓存。缓存键里的引擎集合取的是冷却过滤之前、这次运行会用的集合,所以某家进入或离开冷却不会让刚写进去的条目失效。
冷却针对「抓公开结果页被拦」这件事:SEARCH_THROTTLED(429)、SEARCH_BLOCKED(403、其他 4xx、回显校验不通过)、SEARCH_TIMEOUT、SEARCH_NETWORK 会让引擎休息;SEARCH_PARSE(上游改版,重试没用)和 SEARCH_ABORTED(调用方取消)不冷却。时长优先用对方给的 Retry-After(秒数或 HTTP 日期,取最后一次跳转的响应头),没有就 baseCooldownMs × 2^(连续失败次数−1),封顶 maxCooldownMs。成功一次清零。全都在冷却时仍然照常尝试,不会让引擎集合空掉。
硬盘上的缓存
cachePersist(默认 true)决定要不要写文件;cacheFile 默认空,解析成 ~/.dsh/cache/dsh-web-search/cache.json(开头的 ~ 会展开)。文档结构是 { version: 1, savedAt, entries: [{ key, expiresAt, sources }] },每条只带摘要——url、title、snippet、publishedAt;源对象上多挂的其他字段在序列化边界丢掉,正文永远不会进文件。
- 写:先写到同目录的临时文件(
<file>.<pid>.<n>.tmp),再rename覆盖目标;同一文件系统上是原子操作,rename 之前失败会保留旧文件并删掉临时文件。写入有 2 秒节流,插件卸载和进程退出时也会各刷一次。 - 读:文件不存在、读不了、JSON 坏、
version不符、单条不合法,一律当成空缓存;读取过程从不抛错,也绝不会让插件挂载失败。 - 上限:序列化后的文档按最久未用顺序淘汰,直到不超过 4 MiB(
DEFAULT_CACHE_FILE_MAX_BYTES);cacheEntries仍然约束内存里的条数。 - 过期:
expiresAt是绝对时间,从硬盘载入的条目沿用原截止时间;载入时就丢掉过期条目,重启不会给缓存续命。 - 两个进程:后写覆盖。可能用较旧的快照盖掉较新的,但不会写出半个文件。
- 实时读取:
cacheTtlMs和cacheEntries是每次使用都调用的函数,设置页改完下一次搜索就生效;cachePersist和cacheFile在挂载时决定接线,改这两项要重启。
web_fetch 的四级梯队
web_fetch 的提供方 http-proxy 有四条路:前两条是传输,第三条是可选的浏览器渲染,第四条是 AnySearch 抽取。
| 级别 | 做什么 | 超时 | 什么时候有用 |
|---|---|---|---|
| 1. 直连 | 直接请求目标网址 | 最多 5 秒(DIRECT_DEADLINE_MS = 5000) | 网络通畅时最快,也不浪费隧道的往返 |
| 2. 本地隧道 | 通过 HTTP CONNECT 代理请求 | 用 timeoutMs,默认 15 秒 | github.com、html.duckduckgo.com 这类直连超时的站点 |
| 3. 浏览器渲染(可选) | 用 Playwright 开无头 Chromium,执行页面脚本后取回 DOM | 用 renderTimeoutMs,默认 15 秒;DOM 就绪后再最多等 2 秒 networkidle | 自己装了 Playwright,且页面是壳、或 403/429 但仍带内容。在本机执行,不要 key,不把 URL 交给第三方 |
| 4. AnySearch 抽取 | POST https://api.anysearch.com/v1/extract,服务端渲染后回正文 | 同上,默认 15 秒 | 需要 key。能救回对裸请求回 403 的页面 |
直连的截止时间故意比隧道短:被墙的站点通常表现成超时,把整个预算花在一条不可能成功的路上,后面能成功的路就没时间了。
第 3 级不是每次都会跑。renderJs: auto 会先判断「这像不像壳页面」:正文可读字符为 0;或页面是 403/429 但还有内容;或可读字符少于 500;或少于 1200 且带 __NEXT_DATA__、id="root"、__NUXT__、ng-version 这类前端框架标记。404 和其他 5xx 是错误页,不渲染;非 HTML 正文(JSON、纯文本)也不会被当成壳。always 跳过判断、每次抓取都渲染,包括所有传输都失败时单独用浏览器救一次;off 完全禁用。
Playwright 不在依赖里,也不在启动时导入:抓取提供方在第一次需要渲染时做一次带保护的动态 import(),依次尝试 playwright 和 playwright-core,两个都找不到就静默跳过,把原因写进 render 报告。安装用 npm i -g playwright && npx playwright install chromium(或项目内安装),装完要重载插件——加载器会把「没装」这个结论缓存到本次挂载结束。
渲染失败、超时或被中止时,抓取不会因此失败:前一级梯队已经拿到的页面会原样返回,原因写进 render;只有调用方取消才抛错。配了 AnySearch key 时,渲染失败后仍会先试一次抽取,抽取也失败才回退到之前的页面。
诚实说明:本项目开发环境没装 Playwright,所以「渲染后的正文」没有实测数据。已验证的是壳页面能被正确识别、以及没装时静默回退——用 excalidraw.com 实测:HTML 6862 字节、可读仅 10 字符、含 id="root",判定为壳页面,因未安装 Playwright 而回退。
其他细节:只接受 http(s) URL;原始响应体最多保留 1 MiB(1048576 字节)再做转换,超出截断并标记 truncated;非 2xx 是结果不是失败(会原样带回状态码和响应体);只有所有传输和抽取都失败、且没有可回退的页面时才抛错,错误消息里带每一级的原因。渲染后的 DOM 走同一套 Markdown 转换,也仍然受 fetchMaxLength 约束。
从 HTML 到 Markdown
转换不依赖第三方库(src/markdown.ts):容错的词法与树构建,因为真实页面不是 XML;一遍剪枝,去掉界面装饰标签、注释和隐藏节点;一遍正文选择,依次偏好 <article>、<main> / role=main、文本最密的容器;最后渲染标题、段落、列表、代码、引用、分割线、链接、图片和表格。
markdown保留语法,text只留文字。实体会解码,相对链接补成绝对地址。- 表格转成 Markdown 表格;不在选定正文根里的表格会跟导航一起丢掉。
- 字符预算在转换之后才生效:
truncateFetchText按fetchMaxLength切,去掉尾部空白,避免把代理对切成半个,并追加[truncated at 20000 chars; original length 40891 chars; the rest is not shown]。 - 实测
docs.python.org/3/library/urllib.parse.html:119,614 字符 HTML → 40,891 字符 Markdown → 实际返回 20,080 字符。 fetchFormat和fetchMaxLength每次请求重新解析、renderJs和renderTimeoutMs每次抓取重新解析,设置页改完立即生效;proxy、timeoutMs以及缓存接线在挂载时固定。web_fetch不支持续读:宿主的WebFetchRequest只有url一个字段,没有 offset、maxLength、format,所以每次抓取都从头开始。插件另外注册的read_page补上了这个缺口(见「read_page 的管道」);不换工具时,办法仍然是调大fetchMaxLength,或抓更窄的页面。
domain_search 的管道
domain_search 调用
  → 读配置(domainSources / domainLimit / domainTimeoutMs 每次调用重读)
  → 解析代理(配置 → 环境变量 → 系统代理)
  → sources 缺省 = 设置里启用的源;limit 夹到 1–20,缺省用 domainLimit
  → 默认八个源并发 GET,各自独立超时(domainTimeoutMs);其余 26 个按需开启
  → 按源交错合并,截到 limit
  → 返回 { sources, failures, truncated }
34 个源都是公开、免密钥的接口。默认八个是 GitHub 仓库搜索、npm registry、PyPI、arXiv Atom、Wikipedia API、Hacker News(Algolia)、Stack Exchange API、crates.io;按需的 26 个覆盖包仓库(Docker Hub、Maven、NuGet、RubyGems、Packagist、pub.dev)、代码托管(GitLab、Codeberg、GitHub issues)、模型与数据集(Hugging Face)、编辑器(Open VSX、JetBrains)、基础设施(Terraform 模块与 provider、WordPress)和数据源(OpenAlex、Crossref、Europe PMC、UniProt、ClinicalTrials.gov、NVD、CoinGecko、Internet Archive、Wikidata、Nominatim)。每个源各有解析器,上游改版时该源退化成空结果,不会让整次调用失败;单个源超时、回 5xx 或网络不通,只记一条 failures,其余源照常返回。GitHub 与 crates.io 要求带 User-Agent,请求里已经带上。
两个源的行为需要单独说明:
- PyPI 没有公开搜索 API,所以它不是全文搜索:取查询的第一个词当精确包名去查,包不存在就按空结果处理(不是失败)。
- Wikipedia 只查单一语言:查询里含中日韩字符(CJK)就查
zh,否则查en。
工具注册走宿主真实的工具注册表:用 ctx.get('tools') 读取,而不是 inject——inject 是硬依赖,没有工具服务的部署会连插件都挂不上,web_search 也会跟着消失。读不到就不注册 domain_search,插件其余功能照常。如果这个名字已被别的插件占用,会改用 web_domain_search 注册。
search_many 的管道
search_many 调用
  → queries 1–5 条(必填),limit 缺省 5(取值 1–20),withSites 缺省 false
  → 用 SEARCH_MANY_CONCURRENCY = 3 对查询做 mapLimit
  → 每条查询:与 web_search 相同的引擎层、缓存和冷却记录
  → 抛出的查询变成 { sources: [], failures: [消息] },整批继续
  → 结果保持输入顺序;withSites 时附带小写域名字段 `site`
  → 返回 { results, truncated }
配置里的 limit 是每条查询的硬上限:调用方可以要得更少,不能要得更多。工具自身超时 30 秒,声明为可并发;search_many 被别的插件占用时注册成 web_search_many。和 domain_search 一样从 ctx.get('tools') 取注册表:宿主没有工具注册表就不注册,插件其余功能照常。
read_page 的管道
read_page 调用
  → 读配置(fetchMaxLength / fetchFormat / 抓取相关设置每次调用重读)
  → 校验参数:url 只接受 http/https;offset 默认 0;maxLength 1000–200000;format markdown/text
  → 查插件内的页正文缓存(键:URL + 格式 + 影响抓取的设置;最多 8 页,按最久未用淘汰)
  → 未命中:用与 web_fetch 相同的抓取梯队抓一次并转换
      (内部不按 fetchMaxLength 截断;整页硬上限 2,000,000 字符,超出标记 truncated)
  → 按 offset / maxLength 切片(切点会拆开代理对时回退一个 code unit)
  → 返回 { url, content, offset, nextOffset, totalLength, truncated, chunk, failures }
参数:url(必填)、offset(可选,默认 0,零起始)、maxLength(可选,默认取设置里的 fetchMaxLength;该值不合法时回退到 20000;范围 1000–200000)、format(可选 markdown / text,默认取 fetchFormat)。
返回:url、content(这一段正文)、offset、nextOffset(下次该传的 offset;读完为 null)、totalLength(整页正文长度)、truncated(来源本身是否被截断:2,000,000 字符安全上限或传输层截断)、chunk(index 从 1 开始,count 按本次 maxLength 估算)、failures(抓取失败,形状与 domain_search / search_many 相同)。
缓存:成功的整页正文按「URL + 输出格式 + 影响抓取的设置」缓存,最多 8 页,按最久未用淘汰;因此一页分几段读也只抓一次,只有换格式或改代理、超时、渲染设置、AnySearch key 才会重新抓。失败不缓存。content 里不含「还剩多少字符」那行提示,所以各段 content 直接拼接就是完整正文。
边界:offset 超过 totalLength 直接报错;offset === totalLength 视为读完,返回空 content 与 nextOffset: null;非 http/https 报错;网络、HTTP 状态或拦截失败以 failures 返回,不抛给宿主;调用方取消仍然抛出。切片按 JavaScript 字符串的 code unit 计数,切点落在代理对中间时回退一个 code unit,nextOffset 跟着回退后的边界走。
注册与降级:宿主没有 ctx.tools 时整个工具不注册,web_search 和其他功能照常;read_page 这个名字已被别的插件占用时,注册为 web_read_page;注册表拒绝注册时只写一条警告并跳过。
实测:https://docs.python.org/3/library/asyncio-task.html,从 offset=0 起按 nextOffset 连续读,拼接结果与一次性完整正文逐字符相等(联网,1.3 秒)。测试里对应的一条联网用例默认跳过,设 READ_PAGE_LIVE=1 才运行。
检索质量基准(bench/)
bench/queries.json 固定 20 条查询:中文 10、英文 10;文档 / 版本发布 / 包与库 / 新闻四类各 5 条;每条 1–3 个期望域名。bench/fixtures/<id>.json 保存各引擎当时的原始列表,评测时按夹具里的 recordedAt 重放,所以新鲜度不会随真实时间漂移。
| 命令 | 做什么 |
|---|---|
node scripts/bench.mjs | 离线评测:读夹具、重跑当前排序,输出 P@8 / R@8 / MRR@8、每个引擎的贡献和共识票 |
node scripts/bench.mjs --record | 联网重录夹具,每条查询间隔 1.5 秒,失败重试一次 |
node scripts/bench.mjs --json | 机器可读结果,便于版本间对比;历史结果存在 bench/results/ |
node scripts/bench.mjs --compare <file> | 与一份旧结果逐项对比 |
node scripts/bench.mjs --rrf 40 --weight anysearch=1 --authority-boost 0 | 不改源码做单变量对照 |
指标:P@8 = 前 8 条里命中期望域名的行数 ÷ 8(固定分母,返回不足 8 条也不放宽);R@8 = 前 8 条覆盖的期望域名 ÷ 全部期望域名;MRR@8 = 第一条命中的排名倒数,20 条取平均,没命中记 0。域名匹配允许「子域命中父域」单向成立:docs.python.org 命中期望的 python.org,反过来不算。
当前基线(0.24.x 重放;沿用 0.15.0 的 tier 回放协议):
| 范围 | P@8 | R@8 | MRR@8 |
|---|---|---|---|
| 全部 20 条 | 0.4375 | 0.7917 | 0.8071 |
| 中文 10 条 | 0.4000 | 0.8167 | 0.7976 |
| 英文 10 条 | 0.4750 | 0.7667 | 0.8167 |
对照实验(同一批夹具,只改一个参数):
| 配置 | P@8 | R@8 | MRR@8 |
|---|---|---|---|
| 默认(rrf 60、AnySearch 权重 2) | 0.4375 | 0.7917 | 0.8071 |
| AnySearch 权重 1 | 0.4625 | 0.7917 | 0.8167 |
| rrf 40 | 0.4313 | 0.7833 | 0.8333 |
| rrf 120 | 0.4375 | 0.7917 | 0.8167 |
| 关掉权威域名(authority 0) | 0.3438 | 0.7917 | 0.8071 |
结论:
- 在这份语料上,单变量改动都不能与默认显著分开。
rrf 40把 MRR 从 0.8071 抬到 0.8333,但 P@8 从 0.4375 降到 0.4313,还多出一条 0 命中;rrf 120和权重 1 大约提升 0.01 MRR、P@8 不掉,但 81 组扫描的配对 bootstrap 区间都压到 0,所以默认值都没有改。 - 权威域名加权改变的是同分排序,而不是找出新行:关掉后 P@8 从 0.4375 掉到 0.3438,但 MRR 和 R@8 不变。它存在的意义就是把同排名上的
kubernetes.io压过 SEO 页,数字与这个定位一致。 - AnySearch 权重 2 时它占了 76% 的 top-8 槽位(160 行里 122 行);降到权重 1,P@8 升到 0.3875,但 MRR 掉到 0.7433,偏重与偏轻各有代价。这几组参数的差异只值 1–4 个命中,样本又只有 20 条,所以默认暂时不改。
- 已知短板:新闻类 recall 只有 0.3667(约 0.367);
zh-linux-6120 命中(kernel.org / lwn 被 AWS 文档、菜鸟教程压过);20 条样本没有统计显著性。这些数字用来判断方向,不用来宣布「质量已达标」。
代理
Node 的全局 fetch 既不读操作系统系统代理(macOS 的 scutil、Windows 的 Internet 设置),也不读 HTTPS_PROXY——除非进程启动时带了 NODE_USE_ENV_PROXY=1,而这个开关在进程跑起来之后打不开。所以需要代理时,插件自己连:发 CONNECT、对 https: 目标做 TLS 升级、手写请求、自己解析 Content-Length / chunked / gzip / deflate / brotli,最多跟 4 次跳转。307/308 保留方法和请求体,其他 3xx 把 POST 降级成无 body 的 GET。
代理来源顺序:配置里的 proxy → 环境变量 DSH_WEB_SEARCH_PROXY / HTTPS_PROXY / ALL_PROXY / HTTP_PROXY(大小写都认)→ 操作系统系统代理(macOS scutil --proxy / Windows Internet 设置,带 400 ms TCP 探测,结果缓存 60 秒)。只支持 HTTP 代理;socks5:// 请换成客户端的 HTTP/mixed 端口。代理只作用于本插件,应用其他流量走原来的路。
已知限制
- 相关性受上游结果页限制,整体不如商业搜索 API。免密钥抓取会碰到限流:实测 360 会回
访问异常页面加验证码,另一家国内引擎回x5sec惩罚页。现在这类页面会被识别成SEARCH_BLOCKED(不再伪装成 0 条),360 也已降为兜底档;冷却和多引擎互补仍然只是兜底,兜不住全部。 - Google 在本网络下不可达:走隧道请求
www.google.com/search只回 JS 空壳(94 KB、1–3 个链接),无头 Chrome 被重定向到google.com.hk并回 reCAPTCHA;gbv=1、consent cookie、移动端 UA 都试过,均无效。8 个公共 SearXNG 实例同样不可用(429/403/非 JSON)。 - 依赖上游 HTML 结构。上游改版会让解析失败,此时该引擎记一条原因并让位,不会静默返回空列表。
- 结果里只有标题、链接、摘要,没有正文。正文要
web_fetch。 web_fetch抓回来的正文不能从中间续读:宿主的WebFetchRequest只有url一个字段,超过fetchMaxLength的部分要靠read_page接着读,或调大上限、抓更窄的页面。read_page一页最多留 2,000,000 字符:超过的部分会被硬上限截掉并标记truncated;插件内最多缓存 8 页正文,第 9 页会挤掉最久未用的那一页。- 正文提取只保留「像正文」的部分:纯 JavaScript 渲染的页面默认抓回来接近空壳;自己装了 Playwright 并开启
renderJs才会执行脚本。选定正文根之外的内容(比如侧栏里的表格)仍会跟导航一起丢掉。 - 浏览器渲染没有真实正文的实测数据:本项目开发环境没装 Playwright;已验证的是壳页面识别、无渲染器时的静默回退,以及用注入的假渲染器跑通的渲染、超时和回退路径(
render-js.test.ts)。真实站点「渲染后的正文」尚未测量。 - 基准只有 20 条查询:新闻类 recall 0.367,
zh-linux-6120 命中;参数差异只值 1–4 个命中时不足以区分版本。它用来判断方向,不是统计显著性。 search_many一次最多 5 条查询,批内最多 3 条并发。- 两个进程共用一个缓存文件是后写覆盖:不会写坏文件,但一个进程较新的快照可能被另一个进程较旧的快照盖掉。
- 时间窗只能过滤「有日期」的结果:日期从结果页解析,引擎不给日期时这条就没有年龄信息;窗口内一条带日期的都没有时会退回无日期结果,并在
Note中说明这些行没有被证明落在窗口内。Bing 与 360 的时间参数实测无效,真正下推的只有 DuckDuckGo 的df=。 - 领域搜索是发现,不是完整记录:GitHub 搜索不返回 release tag,Wikipedia 搜索不返回修订时间,Hacker News 搜索不返回最高赞评论,Stack Overflow 搜索不返回 accepted answer 正文;要精确记录时用
web_fetch或read_page追一层。 - PyPI 只支持精确包名:它没有公开搜索 API,插件取查询的第一个词当包名;拼错就是空结果。
- Wikipedia 只查单一语言:含中日韩字符查
zh,否则查en。 - 社区平台是尽力而为:B 站、V2EX、Reddit、YouTube、掘金会改接口或拦截自动请求;工具会退到限定域名的网页搜索,并按平台域名过滤。知乎在本环境没有可用的免密钥 API,只能走兜底,仍可能一条都拿不到。
cache_search只在进程内:research 正文最多保留 7 天、24 篇、每篇 40 万字符,重启即消失;不会写进搜索结果缓存。- 官方站补查有边界:
research只对少数发布机构(欧盟、网信办、Chrome Releases、Python、Redis、W3C)补聚焦site:查询,其他官方机构仍靠普通排序。 - 时间窗不能凭空造日期:所有结果都没有日期时,
advanced_search/domain_search会在note里说明,不会把无日期结果说成在窗口内。 - 插件自有工具都依赖宿主提供工具注册表:没有
ctx.tools时domain_search、search_many、advanced_search、read_page、research、cache_search、platform_search、engine_test都不注册,web_search不受影响。 - AnySearch 匿名调用每次最多 10 条。
- 只支持 HTTP 代理,不支持
socks5://。 limit上限 20;domainLimit上限也是 20。
默认值速查
| 项 | 值 |
|---|---|
返回条数 limit | 8(1–20) |
时间窗 timeRange | off(不限;day / week / month / year) |
domain_search 时间窗 | 省略(不做本地过滤);off / day / week / month / year |
platform_search 条数 | 5(1–10) |
| research 正文缓存 | 24 篇、每篇 40 万字符、7 天,仅内存 |
专用源条数 domainLimit | 5(1–20) |
专用源超时 domainTimeoutMs | 8000 毫秒 |
缓存有效期 cacheTtlMs | 600000 毫秒 = 600 秒 |
缓存条数 cacheEntries | 100 |
写入硬盘 cachePersist | true |
缓存文件 cacheFile | 空 = ~/.dsh/cache/dsh-web-search/cache.json |
| 硬盘缓存上限 | 4194304 字节 = 4 MiB |
单引擎超时 timeoutMs | 15000 毫秒 |
web_fetch 直连截止 | 5000 毫秒 |
| 原始响应体上限 | 1048576(1 MiB) |
返回格式 fetchFormat | markdown(或 text) |
单次抓取字符上限 fetchMaxLength | 20000(1000–200000) |
read_page 分片 maxLength | 取 fetchMaxLength(默认 20000,1000–200000) |
read_page 起始偏移 offset | 0 |
read_page 单页正文硬上限 | 2000000 字符 |
read_page 正文缓存 | 8 页,按最久未用淘汰 |
JS 渲染 renderJs | auto(或 always / off) |
渲染超时 renderTimeoutMs | 15000 毫秒(1000–120000) |
search_many 查询数 / 并发 | 1–5 条 / 3 条 |
search_many 条数 limit | 5(1–20) |
RRF 常数 rrfConstant | 60 |
基础冷却 baseCooldownMs | 300000 毫秒 = 5 分钟 |
最大冷却 maxCooldownMs | 1800000 毫秒 = 30 分钟 |
开发与测试
npm test                        # 全部离线测试(联网用例默认跳过)
node --test test/proxy.test.ts # 单个文件
npm run typecheck              # tsc --noEmit
npm run build                  # 编译 src/ 到 lib/
npm run check                  # typecheck + 测试
测试默认全程离线、全部通过;唯一需要联网的分段验证默认跳过(READ_PAGE_LIVE=1 时才跑):解析器测试回放 test/fixtures/ 里抓下来的真实响应(含默认八个与 26 个按需源的真实响应),传输测试不开 socket,代理测试只验 parseProxy、proxyFromEnv 和纯函数式的响应分帧,时间窗测试用注入的 now 固定日期;新增的几组覆盖 Markdown 正文提取(markdown.test.ts)、批量查询(search-many.test.ts)、分段续读(read-page.test.ts)、硬盘快照(cache-persist.test.ts)、可选 JS 渲染(render-js.test.ts)和基准计分/重放(bench-metrics.test.ts、bench-replay.test.ts)。其中 read-page.test.ts 有一条真实联网用例默认跳过;联网验证时:
# macOS / Linux
READ_PAGE_LIVE=1 node --test test/read-page.test.ts

# Windows PowerShell
$env:READ_PAGE_LIVE=1; node --test test/read-page.test.ts
CI(.github/workflows/ci.yml)在 Node 24 的 Ubuntu、macOS 与 Windows 上跑 npm ci、npm run typecheck、npm test、npm run build,并检查构建确实产出了 lib/index.js 和 lib/index.d.ts,且 apply 与 Config 都可导入。
改完 src/*.ts 记得构建并重启,否则跑的还是 lib/ 里的旧代码。
相关文档链接
- docs/plugin-settings-form.md:插件配置要出现在设置页,需要同时满足哪四层条件;附一次真实排查的完整过程。
- CHANGELOG.md:每个版本改了什么,以及当时的实测数据。
- docs/architecture.md:模块划分和从
web服务到来源列表的数据流。 - docs/engines.md:每个引擎的请求形状、解析怪癖与实测结论。
- docs/troubleshooting.md:没有结果、代理没探测到、提供方没被选中、冷却卡住。
- bench/README.md:20 条查询的检索基准怎么录制夹具、怎么计分、怎么比较版本。
- README.md:英文版,与中文版逐节对应。
MIT © 2026 fangchenghao,见 LICENSE。