Kerno:在引发PR之前捕获破坏性后端更改和意外副作用
人工智能工具生成后端代码的速度很快,但你仍然需要验证它是否有效。
Kerno是一个验证引擎,可以帮助您在提高PR之前捕获AI后端代码中的破坏性更改。它会自动生成,运行并维护与完整代码库上下文的高质量集成。
当您进行更改时,Kerno根据您的实际服务和依赖项验证它们,以捕获破坏性更改和意外副作用。所有直接在您的终端或IDE与即时反馈。
安装
按需运行 npx (没有安装):
npx @kerno/cli init
或全局安装:
npm install -g @kerno/cli
kerno init
需要 node . js 18 +.
连接到Claude Code或Cursor
kerno init 启动Kerno代理(如果尚未运行),并为AI编码助手打印MCP服务器配置。
克劳德代码 —执行命令Kerno打印:
claude mcp add --transport http kerno http://localhost:<port>/mcp
光标 -将打印的代码片段复制到 .cursor/mcp.json:
{
  "mcpServers": {
    "kerno": {
      "url": "http://localhost:<port>/mcp",
      "transport": "http"
    }
  }
}
一旦连接上,您的AI助手就可以驱动Kerno针对您的实际堆栈生成、运行和验证集成测试。
命令
| 命令 | 描述 |
|---|---|
kerno audit | 审核人工智能辅助开发对该存储库所做的工作 |
kerno init | 启动代理并显示Claude Code和Cursor的MCP配置 |
kerno stop | 停止Kerno代理 |
kerno status | 检查系统状态 |
kerno logs | 从正在运行的代理流式传输工作空间日志 |
kerno login | 登录Kerno |
kerno logout | 从Kerno注销 |
kerno uninstall | 停止代理并删除已安装的二进制文件 |
运行 kerno 没有参数来启动交互式shell,或者 kerno --help 查看所有选项。
全局选项
| 选项 | 描述 |
|---|---|
-w, --workspace <path> | 工作空间路径(默认为当前目录) |
-v, --verbose | 显示Kerno诊断日志 |
--force-update | 强制重新下载代理(适用于 start 和 mcp) |
-V, --version | 显示版本号 |
-h, --help | 显示帮助 |
kerno audit
由postthog特性标志进行门控
kerno-audit(@kerno。IO邮件,在里面env=dev, off inenv=prod). 命令行发送env从BACKEND_URL. 使用已标记的帐户登录;否则audit是未知的。
读取你的git历史并报告AI编码代理到达后发生的变化。 只读,不影响存储库的签出。正常情况下需要几分钟 存储库。局部计算除法官,其中发送小源摘录 到TypeSafe的决策API -参见 法官是如何工作的.
cd your-repo
kerno audit
它提出了两个问题,因为两个问题都不能可靠地从 库:
- 人工智能编码代理什么时候到来? 它建议从代理开始一个月
身份和
Co-authored-by预告片,展示了它使用的证据,还有 接受你的纠正。如果它的两个检测规则与历史不一致, 它说,它不能确定收养日期,而是发明一个月。 - 比较应该使用多少历史? 默认为12个月。 6号给出了 相反的迹象 在真正的仓库里是24个,所以 12个或更多。
然后报告,每个函数后面都有命名函数和提交:
- 重新 -代码库中已经存在的函数。
- 复杂性 -每个变更都有分支,根据存储库自己的分支来衡量 之前的趋势,而不是之前/之后。结果已经是趋势了 “解释”被标记为“混淆”,不出现在标题中。
- 返工 -重写最近提交的代码的以后提交,以及多长时间 更改在第一次重写之前可以保存。
没有AI预告片的提交报告为 unknown,而不是人类:人工智能
数字是参与度的下限,而不是对参与度的衡量。 审计没有
测量缺陷 -它读的是git,而不是bug跟踪器,所以它也不能
确认也不否认AI和bug率。
| 选项 | 描述 |
|---|---|
--root <path> | 要审计的存储库(默认:当前目录) |
--adoption <YYYY-MM|auto|none> | 设置月份,接受检测到的一个无人值守,或运行没有比较 |
--baseline <3|6|12|24> | 被收养前几个月的历史来做对比 |
--plugins <a,b> | 只运行这些指标 |
--budget <usd> | 严格限制模型的运行费用 |
--trace-judge | 完整记录每个模型的要求和答案,以备回顾 |
-y, --yes | 接受每一个默认;没有提示 |
报告在 ~/.kerno/audit/runs/<name>/report.md.
法官是如何工作的
当一个测量值真的无法通过静态分析确定时,一个闭合 关于一个模型的问题,两个函数体,或者 提交消息对和一个文件的差异。它永远不会记录整个更改和 永远不要搜索代码。
这些问题是 TypeSafe的决策API,在OpenAI模型上运行, 通过Kerno的Bifrost网关发送给你们组织。源 因此,从这个存储库离开您的机器。每次运行最多:
| 发送 | 体积 | 为什么 |
|---|---|---|
| 函数体对 | 80个请求,每个函数40行源代码 | 区分重新实现和巧合 |
| 一个提交消息对加上一个文件的diff | 120个请求,每个请求8000个字符 | 区分维修和延期 |
提交困难(仅与 --enable complexity-judge) | 60个请求,每个请求12000个字符 | 区分合理的复杂性增加和可避免的复杂性增加 |
这些是天花板; --budget 通常先绑定。帽子本身就住在里面
〇插件 MAX_JUDGED 和 MAX_QUOTE_LINES 在 plugins/duplication,
MAX_JUDGED 和 DIFF_BUDGET 在 plugins/followups 和 plugins/complexity - - - - - -
所以当它们改变时,这个表必须重新读取。
diff是生的 git diff 输出,所以它带有它 diff --git a/<path> 和
---/+++ 标题: 与repo相关的文件路径,提交也是如此
消息。整个文件、存储库名称和代码库索引不包含在内。
如果TypeSafe在运行过程中有速率限制,或者它所账单的帐户有速率限制
信用耗尽,剩下的问题交给OpenAI决策模型
相反,通过相同的网关,以相同的方式计费。既不是429也不是an
空余额是一个结论,没有回退,运行报告 unjudged
对于所有它没有得到的——衡量我们的并发性和我们的账单
而不是存储库。速率限制在一分钟内转移,然后再尝试
类型安全;一笔空的余额会在接下来的时间里转移,因为
没有人会在审计结束前补上余额。备用答案分别在报告和
标志着 fallback 在账簿和追踪中,所以一个替代判决永远不会
被误认为是主要的。 OPENAI_API_KEY 用你自己的来覆盖入口
账户; AUDIT_FALLBACK_MODEL 选择一个不同的模型。
--trace-judge 记录每个请求并逐字回复
目录,以便您可以准确地读取发送的内容,而不是信任它。
什么都不评判,通过 --budget 0,或者在没有Kerno会话的情况下运行
每一个被判断的措施都报告自己为 unjudged 而不是猜测。
当报告说什么都没读
审计使用codegraph包内附带的树-保姆语法进行解析
为您的平台,并通过读取codegraph的索引 node:sqlite,这
需要节点22。两者都悄无声息地失败了:没有安装的语法是错误的
合法状态,因此运行成功,并且从树中计算每个数字
它从来没有读过。
kerno audit --doctor
直接检查每一个-它安装codegraph如果缺失,索引a 一次性存储库并读取索引,然后解析示例函数 对于每个配置的语法-如果有任何损坏,则退出非零。
  ok    node:sqlite          available on v22.22.2
  ok    codegraph            ~/.kerno/audit/tools/node_modules/.bin/codegraph
  ok    codegraph index      1 symbols read back
  ok    tree-sitter grammars 16 ready: typescript, tsx, javascript, python, ...
它是如何工作的
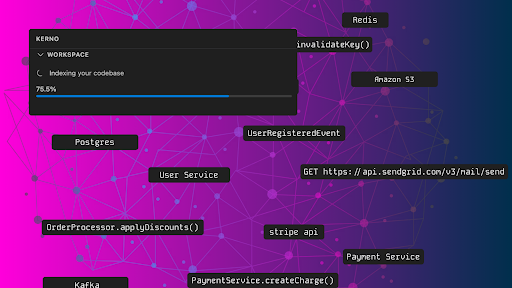
1. 代码库索引
Kerno为您的代码库编制索引,以便深入了解所有内容如何协同工作。Kerno支持TypeScript, JavaScript, Python (Go, PHP, Ruby, Java即将推出)。
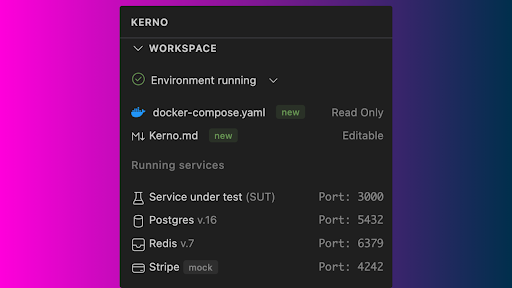
2. 零配置环境编排
Kerno自动协调你的应用程序和它的依赖关系(PostgreSQL, Redis, MongoDB, Kafka, RabbitMQ,等等),无需手动配置。
“Kerno在几分钟内启动并运行,无需手动操作,它使我们的API迁移更加顺畅。我们可以立即验证光标所做的每一个更改都按照我们预期的方式工作,现在它是我们构建的核心部分。” ——Misch Strotz, Letz AI联合创始人兼首席执行官
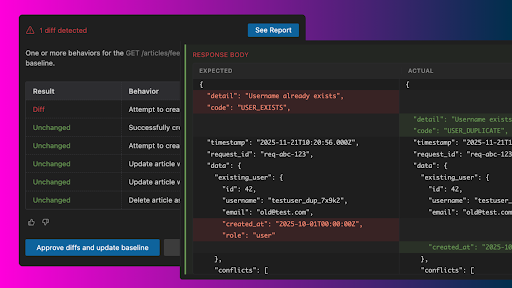
3. 基线捕获和差值检测
Kerno捕获REST端点关键路径的基线行为,然后将代码更改与基线进行比较,并标记任何差异。
Kerno验证:
- 功能性API工作流
- 契约和模式验证
- 错误处理和恢复
- 授权和身份验证
- 边界和边缘情况
“Kerno为我们节省了很多手工工作,并帮助我们捕捉副作用和问题,这些副作用和问题肯定会破坏我们的项目后端。我们的工程团队非常喜欢它。” - BeWise联合创始人兼首席技术官Santiago J. Valls
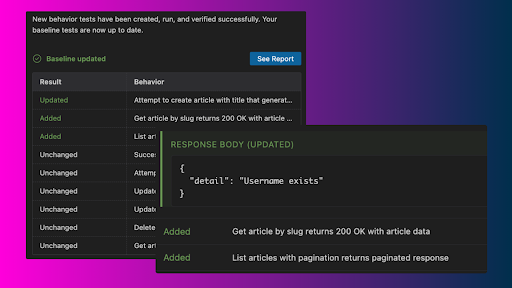
4. 自愈的维护
随着应用程序的发展,Kerno会更新测试以保持所有内容同步,而无需手动操作。在特性出现时添加测试,在代码更改时退出测试——保持套件的完整性和一致性。
为什么球队选择Kerno
- 减少35%的破坏性后端更改和意外副作用
- 为开发者提供3倍的反馈循环,减少PR瓶颈
- 每个开发人员每周可以节省10小时以上的时间来解决ci后的集成问题
“使用Kerno和Claude Code已经改变了游戏规则。您无需手动操作即可获得快速反馈,并且可以节省大量时间和调试合并后集成问题的麻烦。” ——Jonathan Bernales,首席技术官,德国
安全与隐私
- 代码库索引存储在本地 —索引是本地和索引
它会留在你的机器上。
kerno audit例外是:当一个 测量不能静态地解决它发送的源提取物,用 文件的diff头中的路径,到TypeSafe的决策API -参见 法官是如何工作的 具体是什么,在哪里。 - 从未用于培训 -你的私人代码是严格禁止的
- 企业安全 - SOC 2 II型合规正在进行中
- 加密 —传输中的TLS 1.2,静态的AES 256位
什么 kerno audit 收集
对机器的第一次审计将在屏幕上显示此内容,并在执行任何操作之前进行询问
运行。答案被保存在里面 ~/.kerno/audit/sharing.json; kerno audit --data-sharing 又问了一遍。
上载运行和每个查找结果后面的引用代码是 默认的 -包括没有终端机显示有关披露的情况; 例如CI或编码代理。选择退出是一个标志,标志是 下面列出,但是没有人配置的管道将发送结果和 源到作为其登录的组织。没有Kerno会话的运行 上传不了什么,因为没有地方可以发送。
| 在 | 什么 | 当 |
|---|---|---|
| 这台机器 | 仓库,阅读用 git. 报告,缓存和每个运行的工件,在 ~/.kerno/audit. | 总是 |
| 模型提供者,通过Kerno | 每个问题一个小的摘录:一个函数体,一个提交的diff,一个提交消息。账单给你的组织,从来没有用于培训。 | 只有在法官在场的情况下 |
| Kerno | 度量和月度系列,以及它们背后的详细信息——文件路径、提交id和消息、git历史记录中已有的作者姓名和电子邮件,以及每个发现背后引用的函数体。 | 默认情况下 |
| 国旗 | 效果 |
|---|---|
--no-evidence | 上传运行,但去掉引用的函数体 |
--no-upload | 测量并在当地报告;什么也不要寄给Kerno |
--no-judge | 让代码远离模型;判断措施 unjudged |
--local | 这台机器什么都不会离开 |
--data-sharing | 显示披露并再次选择 |
每次上传都记录了它删除了多少引用体,所以“来源是 “移除”是一个数字,而不是一个承诺。上传保存多长时间,如何保存 都在克诺那里 隐私政策.
要求
- node . js 18 +
- 码头工人Kerno使用Docker为测试执行创建隔离的环境。请确保 码头工人的桌面 已在本地机器上安装并运行。
- Git: Kerno只支持Git存储库。确保您的项目是用Git初始化的。
了解更多
问题吗? 加入 Kerno Discord社区.